3 장 여러 테이블의 결합을 통한 검색 (JOIN 검색)
JOIN
- Join은 여러 테이블의 데이터를 결합하여 한번에 검색할 수 있는 기능
- 두 개 이상의 테이블을 조인하려면 공통키가 적어도 하나 이상 있어야 함
3.1 MySQL JOIN의 종류
SQL조인은 그림의 집합연산처럼 다양함
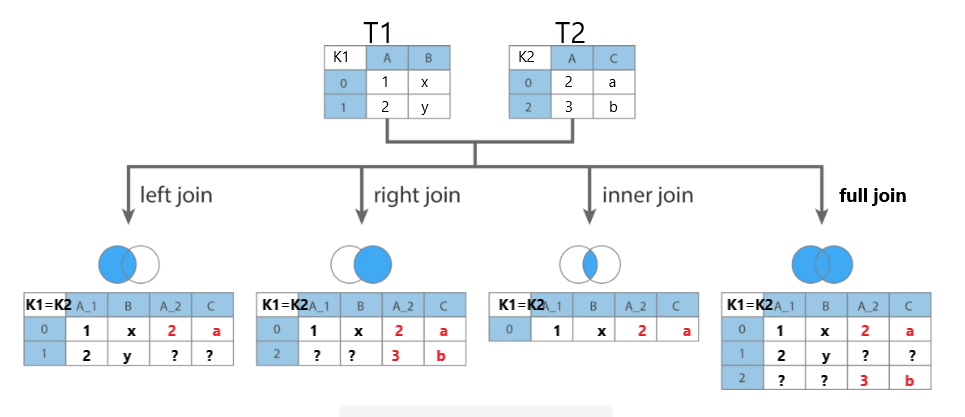
- inner
- outer (left, right, full)
- cross
- self
(예제) 아래와 같이 두개의 테이블을 생성하자.
CREATE TABLE t1(
  id1 INT,
  v1 CHAR(1)
);
CREATE TABLE t2(
  id2 INT,
  v2 CHAR(1)
);

INSERT INTO t1 VALUES(1, 'a');
INSERT INTO t1 VALUES(2, 'b');
INSERT INTO t1 VALUES(3, 'c');
INSERT INTO t2 VALUES(2, 'c');
INSERT INTO t2 VALUES(3, 'b');
INSERT INTO t2 VALUES(4, 'a');

SELECT * FROM t1;
SELECT * FROM t2;
mysql> SELECT * FROM t1; +------+------+ | id1 | v1 | +------+------+ | 1 | a | | 2 | b | | 3 | c | +------+------+ 3 rows in set (0.00 sec) mysql> SELECT * FROM t2; +------+------+ | id2 | v2 | +------+------+ | 2 | c | | 3 | b | | 4 | a | +------+------+ 3 rows in set (0.00 sec)INNER JOIN (내부조인):
t1table의id1과t2table의id2가 같은 레코드를 결합mysql> SELECT t1.*, t2.* FROM t1 INNER JOIN t2 ON t1.id1 = t2.id2;+------+------+------+------+ | id1 | v1 | id2 | v2 | +------+------+------+------+ | 2 | b | 2 | c | | 3 | c | 3 | b | +------+------+------+------+ 2 rows in set (0.00 sec)mysql> SELECT t1.id1 as ID, v1, v2 FROM t1 INNER JOIN t2 ON t1.id1 = t2.id2;+------+------+------+ | ID | v1 | v2 | +------+------+------+ | 2 | b | c | | 3 | c | b | +------+------+------+ 2 rows in set (0.00 sec)OUTER JOIN (외부조인)
LEFT JOIN
mysql> SELECT t1.id1 as ID, v1, v2 FROM t1 LEFT JOIN t2 ON t1.id1 = t2.id2;+------+------+------+ | ID | v1 | v2 | +------+------+------+ | 2 | b | c | | 3 | c | b | | 1 | a | NULL | +------+------+------+ 3 rows in set (0.00 sec)RIGHT JOIN
mysql> SELECT t2.id2 as ID, v1, v2 FROM t1 RIGHT JOIN t2 ON t1.id1 = t2.id2;+------+------+------+ | ID | v1 | v2 | +------+------+------+ | 2 | b | c | | 3 | c | b | | 4 | NULL | a | +------+------+------+ 3 rows in set (0.00 sec)FULL JOIN : MySQL에서는 LEFT JOIN의 결과와 RIGHT JOIN의 결과를 합하여 (UNION) 생성
mysql> (SELECT t1.id1 as ID, v1, v2 FROM t1 LEFT JOIN t2 ON t1.id1 = t2.id2)
        UNION
       (SELECT t2.id2 as ID, v1, v2 FROM t1 RIGHT JOIN t2 ON t1.id1 = t2.id2);
+------+------+------+ | ID | v1 | v2 | +------+------+------+ | 2 | b | c | | 3 | c | b | | 1 | a | NULL | | 4 | NULL | a | +------+------+------+ 4 rows in set (0.00 sec)
CROSS JOIN (크로스조인): 두 테이블의 곱 (Catesian product, Cross product)
mysql> SELECT * FROM t1 CROSS JOIN t2;+------+------+------+------+ | i1 | c1 | i2 | c2 | +------+------+------+------+ | 1 | a | 2 | c | | 2 | b | 2 | c | | 3 | c | 2 | c | | 1 | a | 3 | b | | 2 | b | 3 | b | | 3 | c | 3 | b | | 1 | a | 4 | a | | 2 | b | 4 | a | | 3 | c | 4 | a | +------+------+------+------+ 9 rows in set (0.00 sec)아래의 SQL을 실행하고 위의 결과와 비교하라.
SELECT * FROM t1 JOIN t2;
SELECT * FROM t1, t2;
SELF JOIN: CROSS JOIN의 특수한 형태로 자기 자신과의 CROSS JOIN (두 테이블이 동일하기 때문에 별칭(여기서는
AS b)을 정해야 함)mysql> SELECT * FROM t1 CROSS JOIN t1 AS b;+------+------+------+------+ | i1 | c1 | i1 | c1 | +------+------+------+------+ | 1 | a | 1 | a | | 2 | b | 1 | a | | 3 | c | 1 | a | | 1 | a | 2 | b | | 2 | b | 2 | b | | 3 | c | 2 | b | | 1 | a | 3 | c | | 2 | b | 3 | c | | 3 | c | 3 | c | +------+------+------+------+
[연습] 다음의 SQL문을 수행해 보고 위의 결과와 비교해 보시오.
SELECT t1.*, t2.* FROM t1 JOIN t2 WHERE t1.id1=t2.id2;
SELECT t1.*, t2.* FROM t1 JOIN t2 ON t1.id1=t2.id2;
SELECT t1.*, t2.* FROM t1 CROSS JOIN t2 WHERE t1.id1=t2.id2;
SELECT t1.*, t2.* FROM t1 CROSS JOIN t2 ON t1.i1=td2.id2;
3.2 SQL JOIN과 R data.frame, data.table의 merge
| SQL JOIN | R merge() function |
|---|---|
| INNER | merge(X, Y, all=FALSE) |
| LEFT | merge(X, Y, all.x=TRUE) |
| RIGHT | merge(X, Y, all.y=TRUE) |
| OUTER | merge(X, Y, all=TRUE) |
3.3 Join 검색문을 작성하는 순서
SELECT절에서 검색하고 하는 열 이름들을 명시FROM 절에서 SELECT 절에 지정된 열 이름들의 소속 테이블 이름을 명시
FROM 절에 지정된 테이블 이름이 두 개 이상이면, WHERE 절에 조인 조건절을 명시
- 두개 이상의 테이블에서 열이름이 중복을 해결하기 위해서 테이블이름과 열이름을 반드시 점(
.)으로 구분- 예) 두 테이블에 동일 컬럼명
id: 조인문에서는professor.id와student.id를 사용
- 예) 두 테이블에 동일 컬럼명
- 테이블 이름을
AS문을 이용하여 다른 이름으로 변경 가능- FROM 절에서 테이블 이름에 별명을 지정한 후, 조인 조건절(where)에서 지정된 별명을 사용
- 두개 이상의 테이블에서 열이름이 중복을 해결하기 위해서 테이블이름과 열이름을 반드시 점(
3.4 가상 테이블 VIEW
- 뷰(view)
- SQL query를 통해 만들어진 가상 테이블로 일반 테이블은 메모리에 저장되지만 VIEW 데이블은 SQL만 저장됨, 복잡한 QUERY문을 단순화하거나, 서로 다른 작업자가 공유하여 데이터의 중복을 피할 수 있음
뷰의 생성, 삭제
CREATE VIEW 뷰이름 AS (SELECT 구문)
DROP VIEW 뷰이름
VIEW는 일반 TABLE의 조작 구문을 대부분 사용할 수 있으나, 삽입/삭제/갱신/변경(
INSERT,DELETE,UPDATE)은 불가예제
CREATE VIEW tab1 AS
 (SELECT t1.id1 as ID, v1, v2 FROM t1 LEFT JOIN t2 ON t1.id1 = t2.id2);

CREATE VIEW tab2 AS
 (SELECT t2.id2 as ID, v1, v2 FROM t1 RIGHT JOIN t2 ON t1.id1 = t2.id2);

SHOW TABLES; # 아래의 tab1, tab2는 VIEW table임
+-----------------+
| Tables_in_jskim |
+-----------------+
| t1              |
| t2              |
| tab1            |
| tab2            |
+-----------------+

DESC tab1;
+-------+---------+------+-----+---------+-------+
| Field | Type    | Null | Key | Default | Extra |
+-------+---------+------+-----+---------+-------+
| ID    | int(11) | YES  |     | NULL    |       |
| v1    | char(1) | YES  |     | NULL    |       |
| v2    | char(1) | YES  |     | NULL    |       |
+-------+---------+------+-----+---------+-------+

SELECT * FROM tab1;
+------+------+------+
| ID   | v1   | v2   |
+------+------+------+
|    2 | b    | c    |
|    3 | c    | b    |
|    1 | a    | NULL |
+------+------+------+

SELECT * FROM tab1 UNION SELECT * FROM tab2;
+------+------+------+
| ID   | v1   | v2   |
+------+------+------+
|    2 | b    | c    |
|    3 | c    | b    |
|    1 | a    | NULL |
|    4 | NULL | a    |
+------+------+------+
3.5 연습문제
아래의 테이블 정보를 이용하여 테이블을 만들어라.
[my_db_name].code+---------+-------------+------+-----+---------+-------+ | Field | Type | Null | Key | Default | Extra | +---------+-------------+------+-----+---------+-------+ | newcode | char(2) | NO | PRI | NULL | | | oldcode | char(2) | NO | | NULL | | | name | varchar(20) | NO | | NULL | | +---------+-------------+------+-----+---------+-------+[my_db_name].pop+---------+---------+------+-----+---------+-------+ | Field | Type | Null | Key | Default | Extra | +---------+---------+------+-----+---------+-------+ | newcode | char(2) | NO | PRI | NULL | | | sex | char(3) | NO | PRI | NULL | | | year | int(11) | NO | PRI | NULL | | | pop | int(11) | YES | | NULL | | +---------+---------+------+-----+---------+-------+[my_db_name].income+-----------+-------------+------+-----+---------+-------+ | Field | Type | Null | Key | Default | Extra | +-----------+-------------+------+-----+---------+-------+ | oldcode | char(2) | NO | PRI | NULL | | | statistic | varchar(20) | NO | PRI | NULL | | | value | int(11) | YES | | NULL | | +-----------+-------------+------+-----+---------+-------+
SQL구문
#DROP TABLE jskim.code;
CREATE TABLE jskim.code(
  newcode CHAR(2) NOT NULL PRIMARY KEY,
  oldcode CHAR(2) NOT NULL,
  name varchar(20) NOT NULL
  ) DEFAULT CHARACTER SET utf8
    DEFAULT COLLATE utf8_general_ci;

#DROP TABLE jskim.pop;
CREATE TABLE jskim.pop (
  newcode CHAR(2) NOT NULL, # newcode
  sex CHAR(3) NOT NULL,
  year INT NOT NULL,
  pop  INT,
  PRIMARY KEY(newcode,sex,year)
  ) DEFAULT CHARACTER SET utf8
    DEFAULT COLLATE utf8_general_ci;

#DROP TABLE jskim.income;
CREATE TABLE jskim.income (
  oldcode CHAR(2) NOT NULL, # oldcode
  statistic VARCHAR(20) NOT NULL,
  value INT,
  PRIMARY KEY(oldcode,statistic)
  ) DEFAULT CHARACTER SET utf8
    DEFAULT COLLATE utf8_general_ci;
아래의 자료는 자료값이 탭으로 구분된 자료이고 첫번째 라인은 변수명이다. 위에서 생성한 테이블에 각각 입력하여라.
SQL
- code
LOAD DATA LOCAL INFILE "~/lectures2/DB/data/code.txt"
  INTO TABLE jskim.code
  CHARACTER SET utf8
    FIELDS TERMINATED BY '\t'
    LINES TERMINATED BY '\n'
    IGNORE 1 LINES;

LOAD DATA LOCAL INFILE '~/lectures2/DB/data/pop.txt'
    INTO TABLE jskim.pop
    CHARACTER SET utf8
    FIELDS TERMINATED BY '\t'
    LINES TERMINATED BY '\n'
    IGNORE 1 LINES;

LOAD DATA LOCAL INFILE "~/lectures2/DB/data/income.txt"
    INTO TABLE jskim.income
    CHARACTER SET utf8
    FIELDS TERMINATED BY '\t'
    LINES TERMINATED BY '\n'
    IGNORE 1 LINES;
code테이블의 newcode와 pop테이블의 newcode를 이용하여 두 테이블을 JOIN
SELECT A.newcode, A.oldcode, A.name, B.sex, B.year, B.pop
  FROM jskim.code as A RIGHT JOIN jskim.pop as B
  ON A.newcode=B.newcode;

# 뷰(view)의 생성: ----------------------------------------------------------------
#  DROP VIEW jskim.P1;
CREATE VIEW jskim.P1 AS SELECT A.newcode, A.oldcode, A.name, B.pop
  FROM jskim.code as A RIGHT JOIN jskim.pop as B
  ON A.newcode=B.newcode
  WHERE year=2017 AND sex='전체';

SELECT * FROM jskim.P1;

# 뷰(view)의 생성: ----------------------------------------------------------------
#  DROP VIEW jskim.I1;
CREATE VIEW jskim.I1 AS SELECT oldcode, value as GRDP
  FROM jskim.income
  WHERE statistic='GRDP';
  SELECT * FROM jskim.I1;


# 두개의 뷰(view)를 조인: ----------------------------------------------------------------
SELECT newcode, name, pop, GRDP
  FROM jskim.P1 AS A JOIN jskim.I1 AS B
  ON A.oldcode=B.oldcode;

DROP VIEW jskim.P1;

SELECT B.newcode, B.name, A.statistic, A.value
  FROM jskim.income as A JOIN jskim.code as B
  ON A.code=B.oldcode;
아래의 문제를 풀기 위한 SQL을 작성하시오.
- 시도별 2017년 전체 인구수
- 시도별 2011년 전체 인구수
- 위의 두개의 결과를 join한 후 시도별 2011년 대비 2017년 전체 인구 증가율
CREATE VIEW P2017 AS SELECT A.name, A.newcode, B.pop
FROM jskim.code AS A JOIN jskim.pop AS B
ON A.newcode = B.newcode WHERE B.sex = "전체" AND B.year=2017 AND A.name != "전국";

CREATE VIEW P2011 AS SELECT A.name, A.newcode, B.pop
FROM jskim.code AS A join jskim.pop AS B
ON A.newcode = B.newcode WHERE B.sex = "전체" AND B.year=2011 AND A.name != "전국";

SELECT P1.name AS 시도명, P1.pop AS '2017년인구',
P2.pop AS '2011년인구',
P1.pop/P2.pop AS '인구증가율(%)'
FROM jskim.P2017 AS P1 JOIN jskim.P2011 AS P2 ON P1.newcode = P2.newcode;
+-----------------------+---------------+---------------+--------------------+
| 시도명                | 2017년인구    | 2011년인구    | 인구증가율(%)      |
+-----------------------+---------------+---------------+--------------------+
| 서울특별시            |       9857426 |      10249679 |                 96 |
| 부산광역시            |       3470653 |       3550963 |                 98 |
| 대구광역시            |       2475231 |       2507271 |                 99 |
| 인천광역시            |       2948542 |       2801274 |                105 |
| 광주광역시            |       1463770 |       1463464 |                100 |
| 대전광역시            |       1502227 |       1515603 |                 99 |
| 울산광역시            |       1165132 |       1135494 |                103 |
| 세종특별자치시        |        280100 |          NULL |               NULL |
| 경기도                |      12873895 |      11937415 |                108 |
| 강원도                |       1550142 |       1536448 |                101 |
| 충청북도              |       1594432 |       1562903 |                102 |
| 충청남도              |       2116770 |       2101284 |                101 |
| 전라북도              |       1854607 |       1874031 |                 99 |
| 전라남도              |       1896424 |       1914339 |                 99 |
| 경상북도              |       2691706 |       2699195 |                100 |
| 경상남도              |       3380404 |       3308765 |                102 |
| 제주특별자치도        |        657083 |        576156 |                114 |
+-----------------------+---------------+---------------+--------------------+- 아래의 문제를 풀기 위한 SQL을 작성하시오.
- 시도별 개인소득
- 시도별 개인소비
- 위의 두개의 결과를 join한 후 시도별 개인 소득 대비 개인소비 비율
- 시도별 GRDP, 2017년 인구수, 일인당 소득(GRDP/인구수)