제 4 장 기타 감독학습 모형
4.1 Naive Bayes 모형
- 베이즈정리(Bayes Theorem)
-
두 확률 변수의 사전확률과 사후확률 사이의 관계를 나타내는 정리. 베이즈정리는 대표적 경험적(귀납적)인 추론방법임. \(Y\)라는 사건이 일어날 확률을 \(P(Y)\), \(X\)는 관찰값이라고 할 때, \(X\)를 관찰한 후에 \(Y\)가 일어날 확률, \(P(Y|X)\)는 조건부확률의 정의에 따라 아래 처럼 계산할 수 있음
\[ P(Y|X) = \frac{P(X|Y)P(Y)}{P(X)} \propto P(X|Y) P(Y) \]
- 위에서 \(P(Y)\)를 사전확률(prior), \(P(Y|X)\)를 사후확률(posterior)라고 부름
- 조건부 독립(conditional independence)
-
여러 확률변수들에 대한 (조건부) 결합확률이 확률변수별 조건부 확률의 곱으로 표현할 수 있을 때, 이를 조건부 독립이라고 함
\[ P(X_1, X_2, ..., X_p|Y) = P(X_1|Y)P(X_2|Y) \cdots P(X_p|Y) = \prod_{j=1}^p P(X_j|Y) \]
- 1. 나이브베이즈, 단순베이즈 (Naive Bayes method)
- 출력변수가 주어진 경우 입력변수들의 조건부 분포가 독립이라는 가정(단순 베이즈 가정, naive Bayes assumption)하에서 입력값이 주어진 경우 출력변수의 값에 대한 조건부 확률을 추론하는 방법 \[\begin{eqnarray*} P(Y=k|X_1=x_1, \ldots, X_p = x_p) &\propto& P(X_1 = x_1,\ldots,X_p = x_p|Y=k)P(Y=k)\\ &\propto& P(Y=k)\prod_{j=1}^p P(X_j = x_j|Y=k). \end{eqnarray*}\]
위에서 \(P(X_j = x_j|Y=k)\)는 입력변수(\(X_j\))의 속성에 따라 아래와 같이 계산함
연속형 입력변수(\(X_j\)): 정규분포의 확률밀도함수를 이용 \[ P(X_j = x|Y=k) = \frac{1}{\sqrt{2\pi \sigma_k^2}}\exp\left(-\frac{(x-\mu_k)^2}{2\sigma_k^2}\right), \] \(\mu_k\)와 \(\sigma_k^2\)은 \(Y=k\)인 데이터에서 \(X_j\)의 평균과 분산으로 추정함
이진범주형(binary) 입력변수(\(X_j\)): 베르누이분포의 확률질량함수를 이용 \[ P(X_j = x | Y=k) = p_{jk}^x(1-p_{jk})^{(1-x)}, ~~ \hat {p_{jk}} = \frac{N_{jk} + \alpha}{N_k + 2\times\alpha} \] \(N_{k}\)와 \(N_{jk}\)는 각각 (\(Y=k\))인 데이터의 수와 (\(Y=k\) & \(X_j=x\))인 데이터의 수임, \(\alpha\)는 Laplace smoothing이라고 부르며 보통 1을 사용함
- 나이브베이즈방법은 문서분류에 많이 사용하는 방법임
4.2 \(k\)-근방 분류
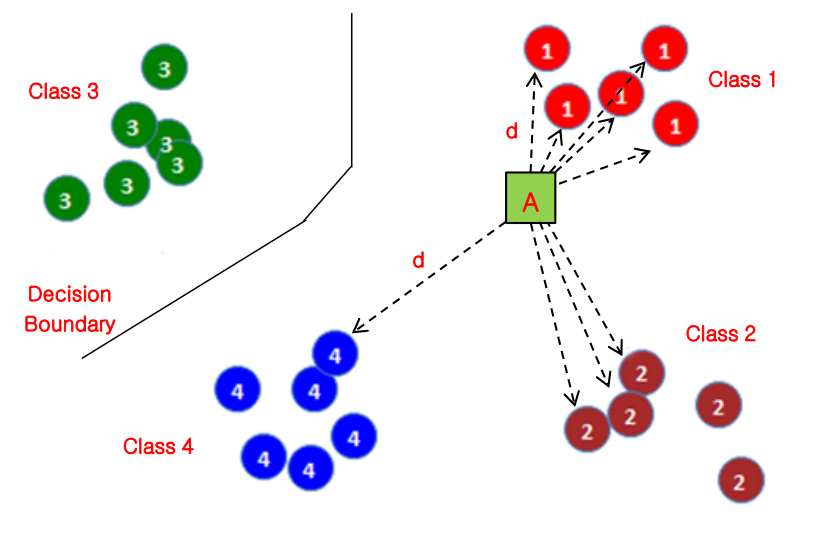
k-근방 분류
- \(k\)-NN은 통계적 모형을 적합하지 않는 메모리 기반의 방법
- \({x}\)점이 주어지면 \({x}\)와 가장 거리가 가까운 \(k\)개의 훈련자료점의 \(y\)값들을 비교
- \(N({x})\)를 \({x}\)와 거리가 가장 가까운 \(k\)개의 훈련자료들의 집합인 \(k\)-근방(k-nearest neighborhood)이라 하면
\[ \hat{y}({x}) = \arg\max_{l \in \{-1, +1\}} \sum_{{x}_j \in N({x})}I(y_j = l) \]
\(k\)가 증가하면 편의는 커지고 분산은 감소한다.
점근적으로 \(1\)-NN의 오분류율은 최적 Bayes 오분류율의 2배를 넘지 않는다고 알려져 있다.
4.3 인공신경망
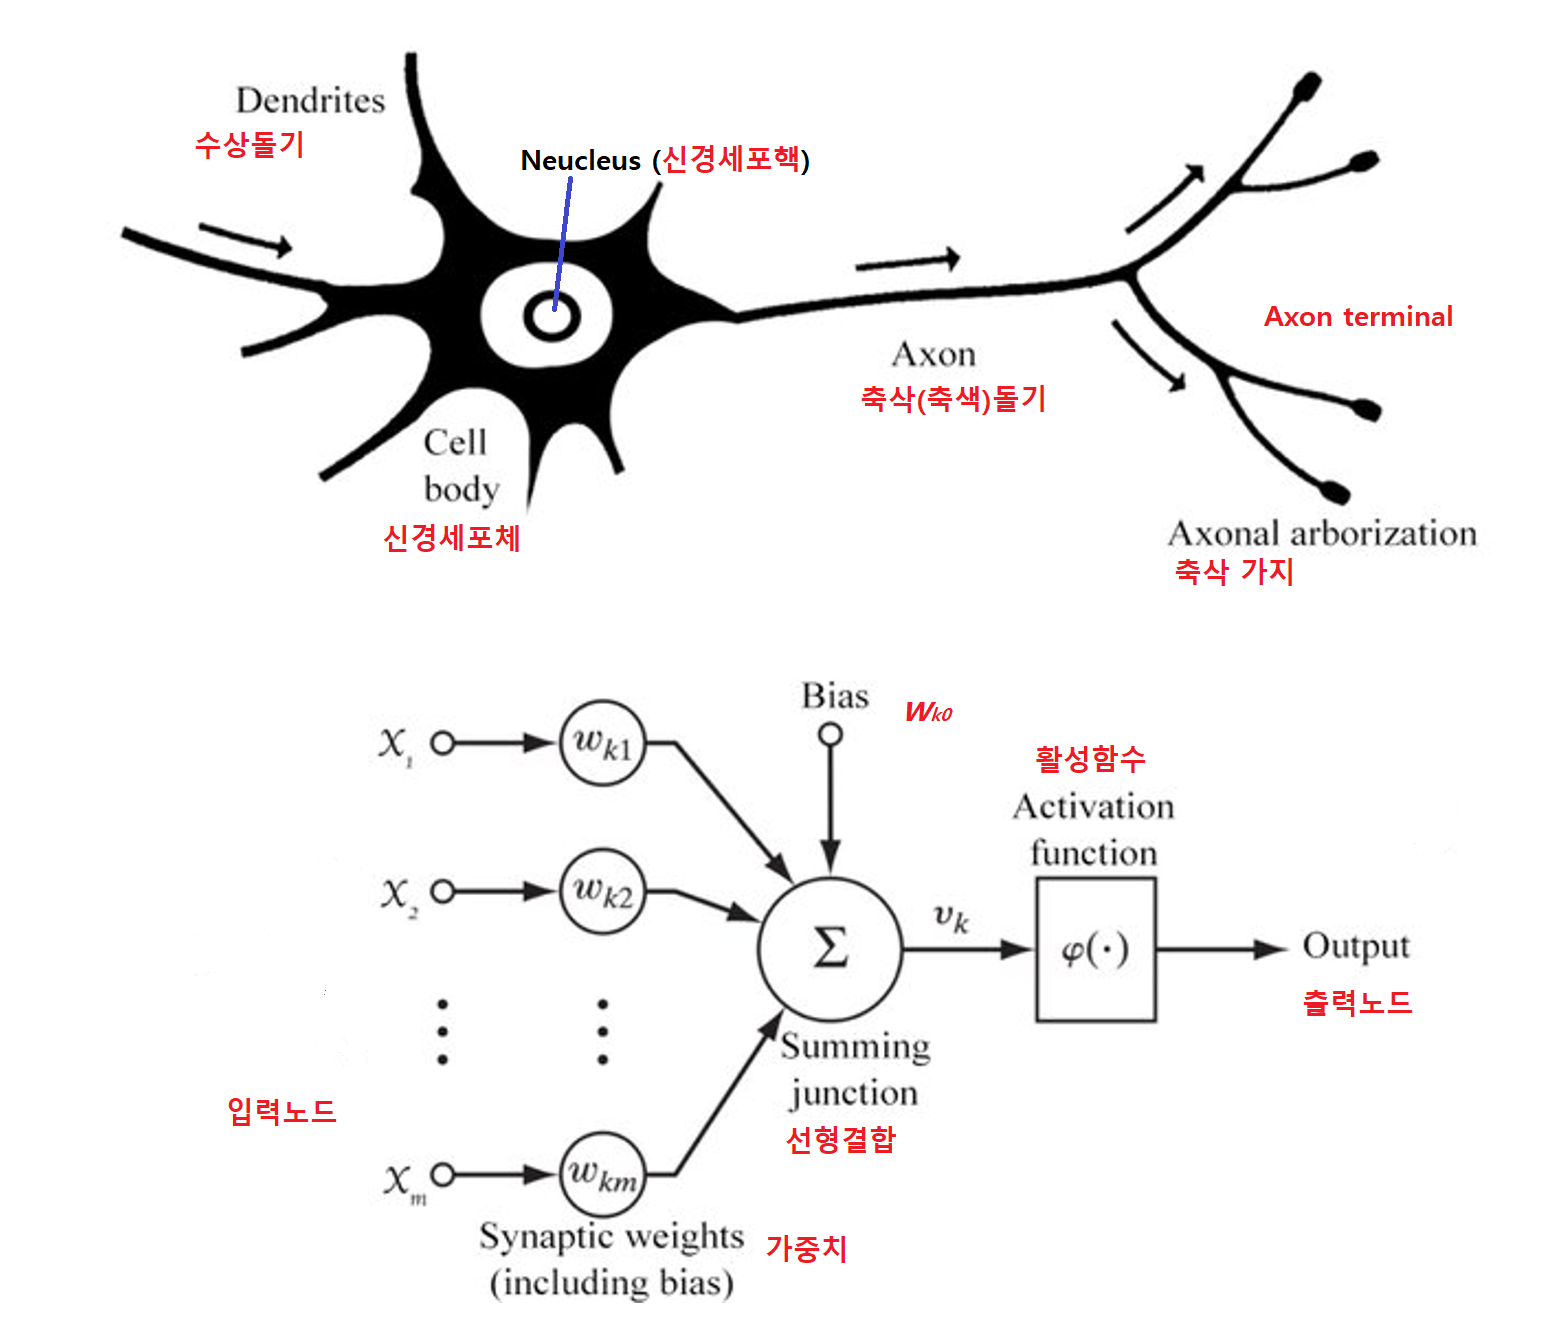
4.3.1 생물학적 뉴런(neuron, 신경세포)의 구조와 인공신경망
- 인간의 뇌는 뉴런이라는 신경세포들로 구성됨
- 수상돌기를 통해 외부 신호(자극)을 받아들이고 신경세포는 신호를 처리하며 시놉스(synopses)를 통해 다른 신경세포로 전달함
4.3.2 신경망의 역사
McCulloch(신경생리학자) & Pitts(수학자) (1943) 신경활동에 뉴런들이 작용하는 것을 이용한 최초의 인공신경망 모델 도입
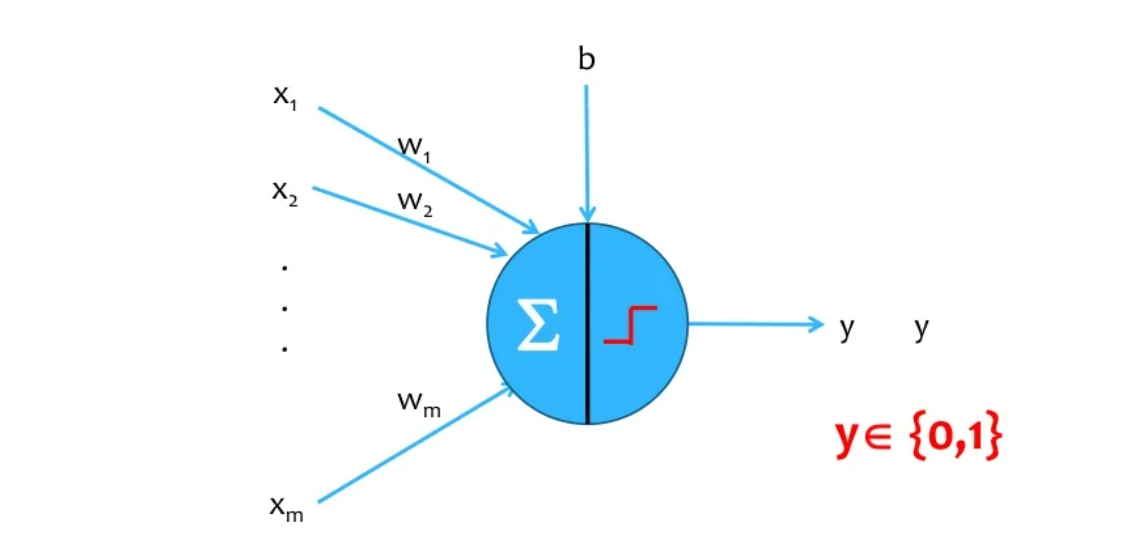
Hebb(1949, 심리학자)는 “행동의 조직화”라는 연구에서 신경망은 사용할 때마다 강화되며 인간의 학습방법에도 필수적인 점을 이용하여 헤비안 학습을 고안하였고 이는 비지도학습인 장기강화(long term potentiation)의 초기 모델임.
Frank Rosenblatt (1958, 심리학자)은 지도학습의 최초모델인 퍼셉트론(Perceptron)을 제안
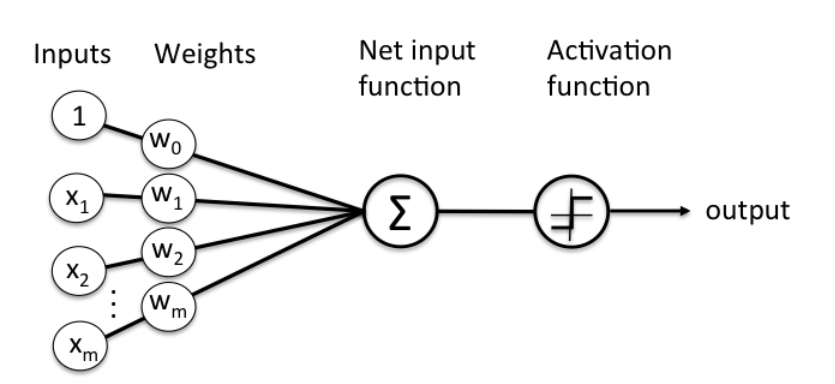
Rosenblatt 퍼셉트론
ADALINE(ADAptive LINEar Element): 1960년에 두 명의 전기 엔지니어 Widrow와 Hoff가 개발. 학습에 사용된 방법은 퍼셉트론과 다르며 최소평균제곱 학습규칙을 사용함
Minsky & Papert (1969): 인공신경망의 문제점 지적. 첫 번째로는 단층 신경망은 배타적-논리합(XOR; eXclusive OR) 문제를 해결하지 못한다는 것. 두 번째는 거대 신경망 계산을 위해서 컴퓨터가 충분히 효과적으로 처리할 만큼 정교하지 않다는 것. 이후 신경망 연구는 암흑기에 접어듬.
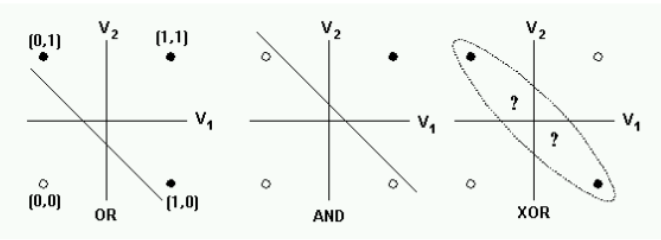
XOR 문제
컴퓨터가 충분히 빨라지고, 배타적 논리합 문제를 효율적으로 처리하는 다중신경망(MLP, multi-layer perceptron)과 오차역전파법(back-propagation)이 만들어지기까지 더디게 진행되었음
McClelland, Rumelhart, Hinton (1986) multi-layer perceptron & back-propagation algorithm 제시
LeCun (1989) MLP와 Convolution 결합, 손글씨 숫자 인식문제(MNIST) 문제에 적용, 1998년 합성곱신경망(CNN, Convolutional Neural Network)의 모태가 되는 LeNet-5 개발
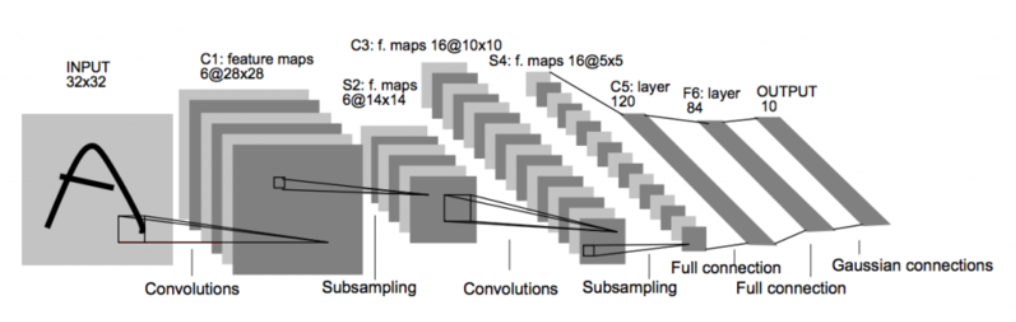
LeNet-5
MLP의 문제점: 레이어가 많을수록 오차역전파알고리즘 수행과정에서 그래디언트소멸(vanishing gradient problem)문제가 발생, 이 시기에 통계적기계학습(Statistical Machine Learning) 기법들 보다 성능이 떨어짐
이후, ReLu 활성함수와 네트워크의 가중치 중 일부를 드롭아웃(drop-out)하는 방법을 도입하여 해결
- 2009년 ~ 2012년: Schmidhuber 등이 재귀신경망 (recurrent network) 개발, Graves 등(2009)은 LSTM 개발
4.3.3 다층신경망
다층신경망 모형의 구조
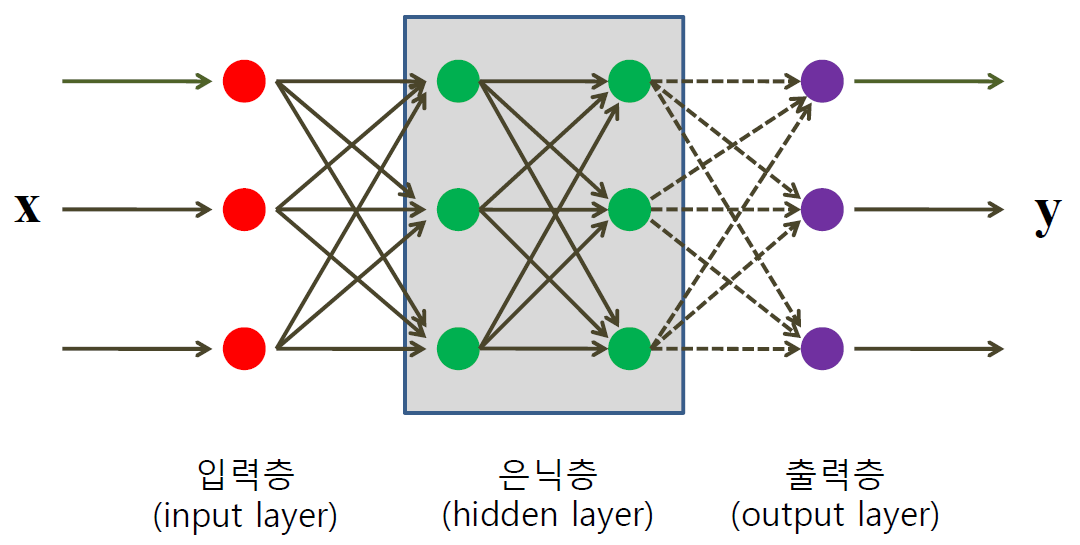
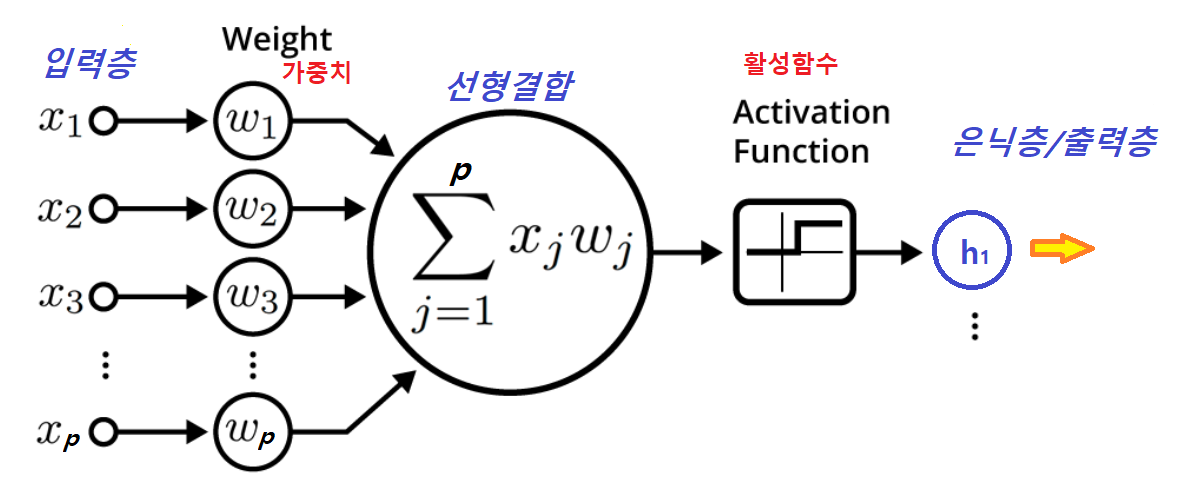
- 입력층(input layer)
- 입력변수에 대응되는 노드로 구성, 노드의 수는 입력변수의 개수
- 은닉층(hidden layer)
- 입력층으로부터 전달되는 변수값들의 선형결합을 비선형함수(활성함수)로 처리, 출력층 또는 다른 은닉층에 전달하는 역할
- 출력층(output layer)
- 출력변수에 대응되는 노드, 분류모형에서는 클래스의 수 만큼의 출력노드가 생성
- 활성함수(activation function)
-
입력노드 혹은 은닉노드의 값에서 그 다음 은닉층에 있는 노드값을 대응시키는 함수를 말하며 다음의 종류가 있음
- identity: \(f(x) = x\)
- logistic: \(f(x) = \frac{1}{1 + e^{-x}}\).
- tanh: hyperbolic tangent - \(f(x) = \tanh(x)\)
- relu: rectified linear unit, \(f(x) = \max(0, x)\)
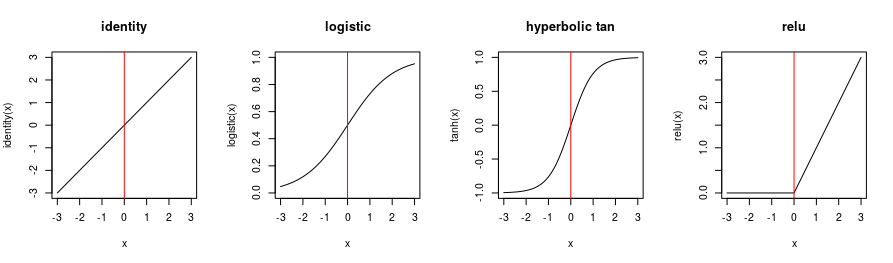
은닉층에서 출력층으로 가는 활성함수는 출력활성함수라고 하며, 분류문제에서는 로지스틱, 회귀문제에서는 선형함수가 사용됨(별도로 지정할 필요가 없음)
신경망학습에서 주의사항: 입력변수의 스케일링, 표준화가 결과에 많은 영향을 미치므로 표준화를 한 후 모형을 학습하기 바람
- 역전파알고리즘(backpropagation algorithm)
- 인공신경망에서 가중치(weights)를 학습하는 방법으로 아래의 절차에 의해 계산하는 알고리즘
- 가중치(weights) 초기값 세팅
- 가중치가 수렴할 때까지 아래 단계를 반복
- (Forward propagation) 주어진 가중치에 대한 인공신경망을 이용 예측치(\(\hat y_i\)) 계산, 예측치와 실제값(\(y_i\))을 이용 오차(\(E\))계산 (MSE 또는 neagtive log-likelihood)
- (Back propagation) 오차함수를 최소화하는 가중치 업데이트: 출력층에서 입력층 방향으로 연쇄법칙을 이용한 기울기경사하강법(gradient descent)을 적용
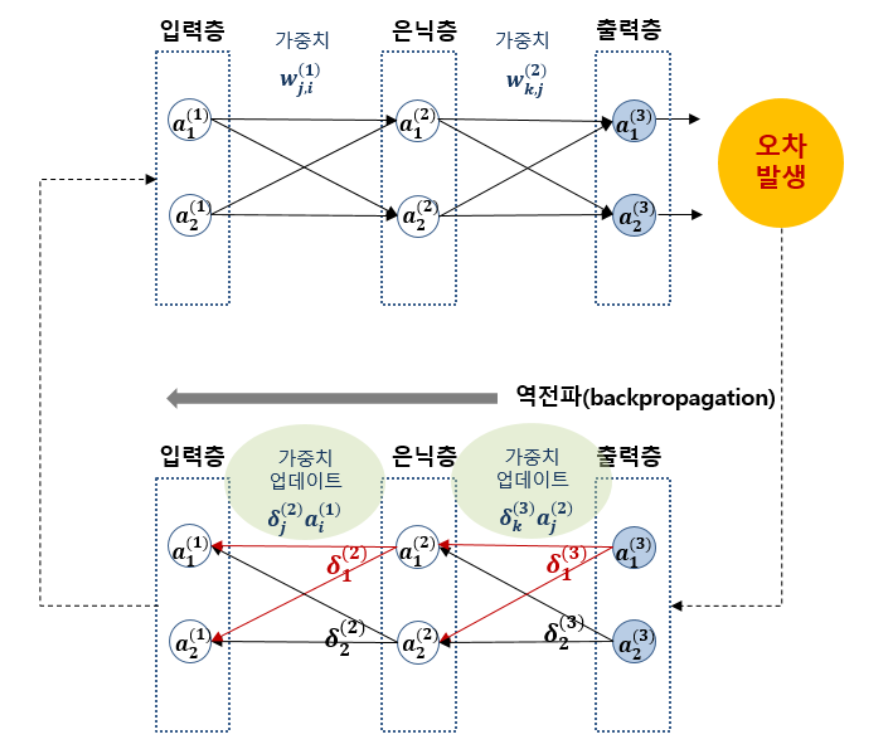
역전파알고리즘
- 기울기경사하강법(Gradient descent alogorithm)
- 함수(\(F(x)\))의 최소점을 찾기 위한 방법으로 특정 \(x\)에서의 미분값 (Gradient, 접선의 기울기)의 반대 방향으로 탐색하는 방법임, 가파를수록 (접선의 기울기가 클수록) 크게 변함 \[ x^{new} = x^{old} - \alpha \frac{\partial F(x)}{\partial x} \]
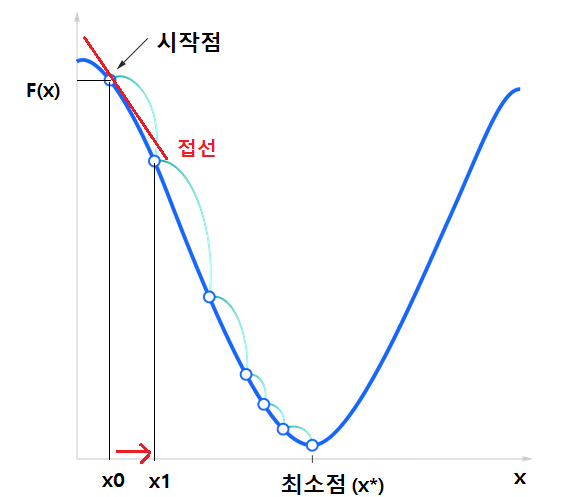
기울기경사하강법
- 드롭아웃(Dropout)
- 인공신경망 학습과정에서 신경망의 뉴런(노드) 중 일부를 랜덤하게 선택하여 사용하지 않도록 하는 방법
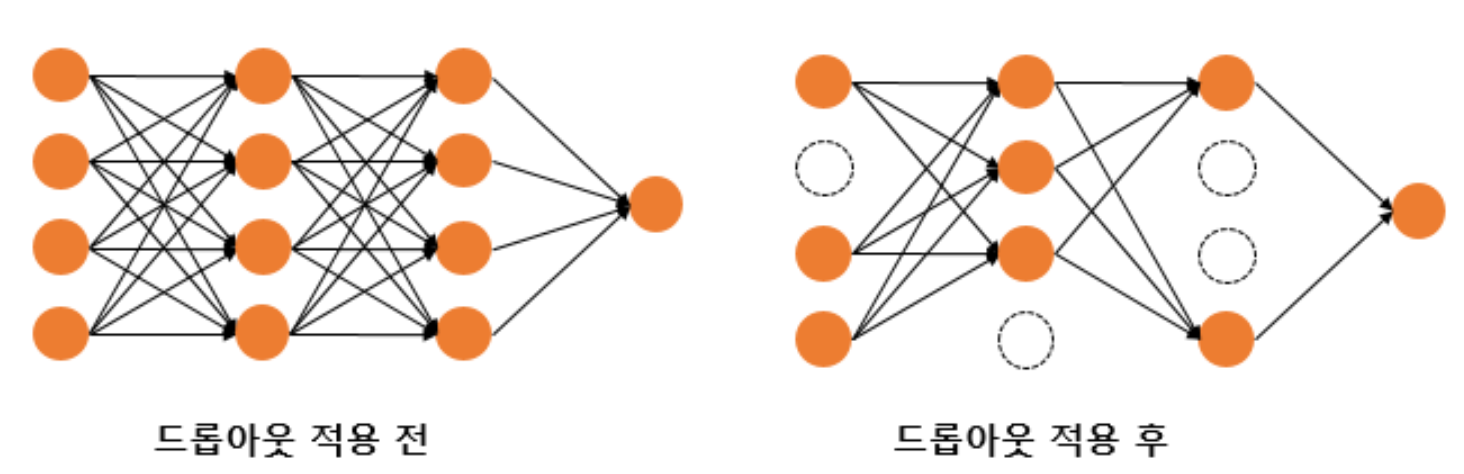
드롭아웃
4.4 SVM
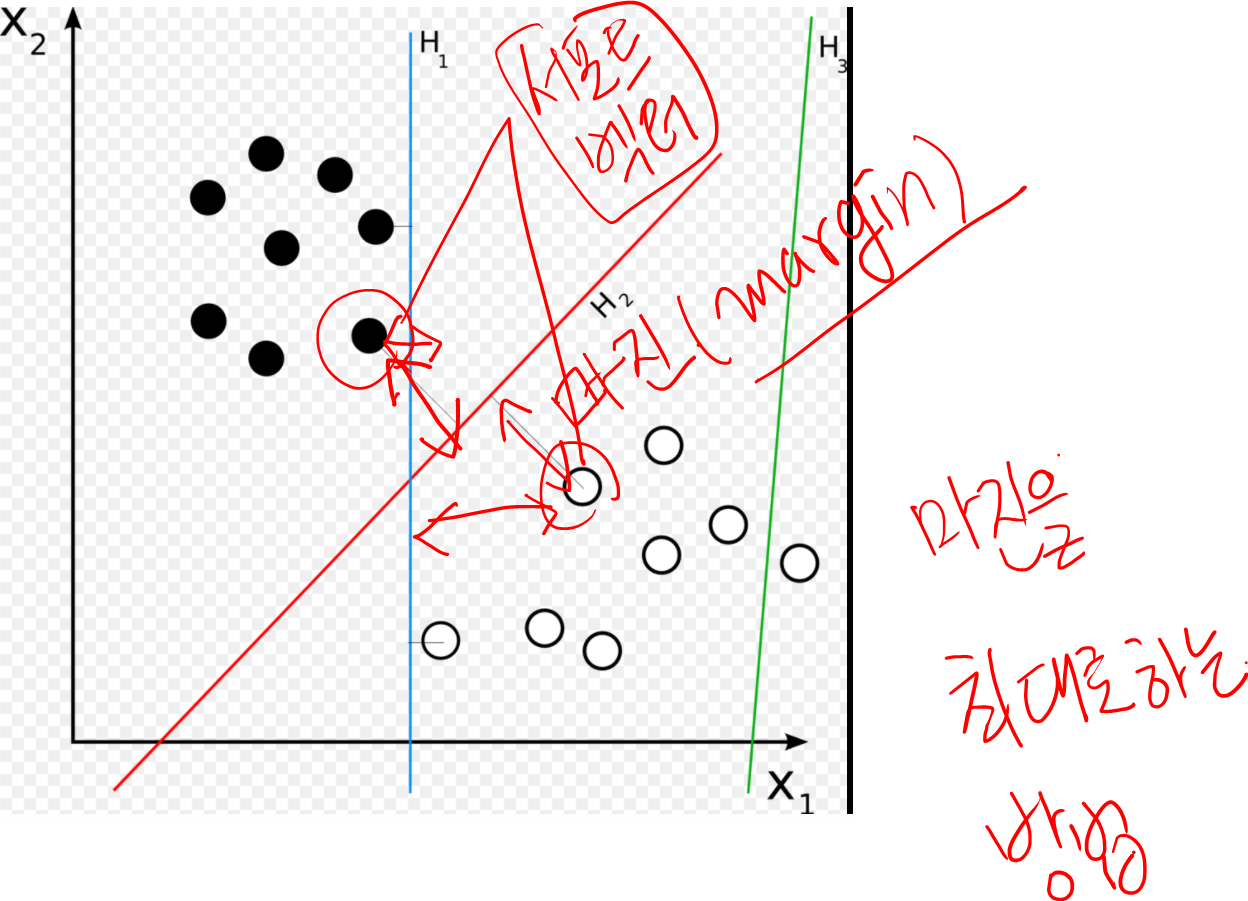
SVM 아이디어
Hinge loss: \[ (1-y_if({x}_i))_+\triangleq \max(1-y_if(x_i), 0), ~ \lambda >0: \text{ tunning parameter}. \]
SVM은 아래의 penalized hinge loss를 최소화하는 방법 \[ \min_{f\in \mathcal{H}} \left( \frac{1}{n}\sum_{i=1}^n (1-y_if({x}_i))_+ + \lambda \|f\|^2 \right). \] \[ f({x}) = \sum_{i=1}^n \alpha_i K({x}_i,{x}) \]
\(f\)는 \(n\)개의 훈련자료점에서 계산된 커널의 선형결합 \[ \min_{{\beta},\beta_0} \left( \frac{1}{n}\sum_{i=1}^n (1-y_i(\beta_0 + \Phi({x}_i)^T{\beta}))_+ + \lambda \|{\beta}\|^2 \right) \]
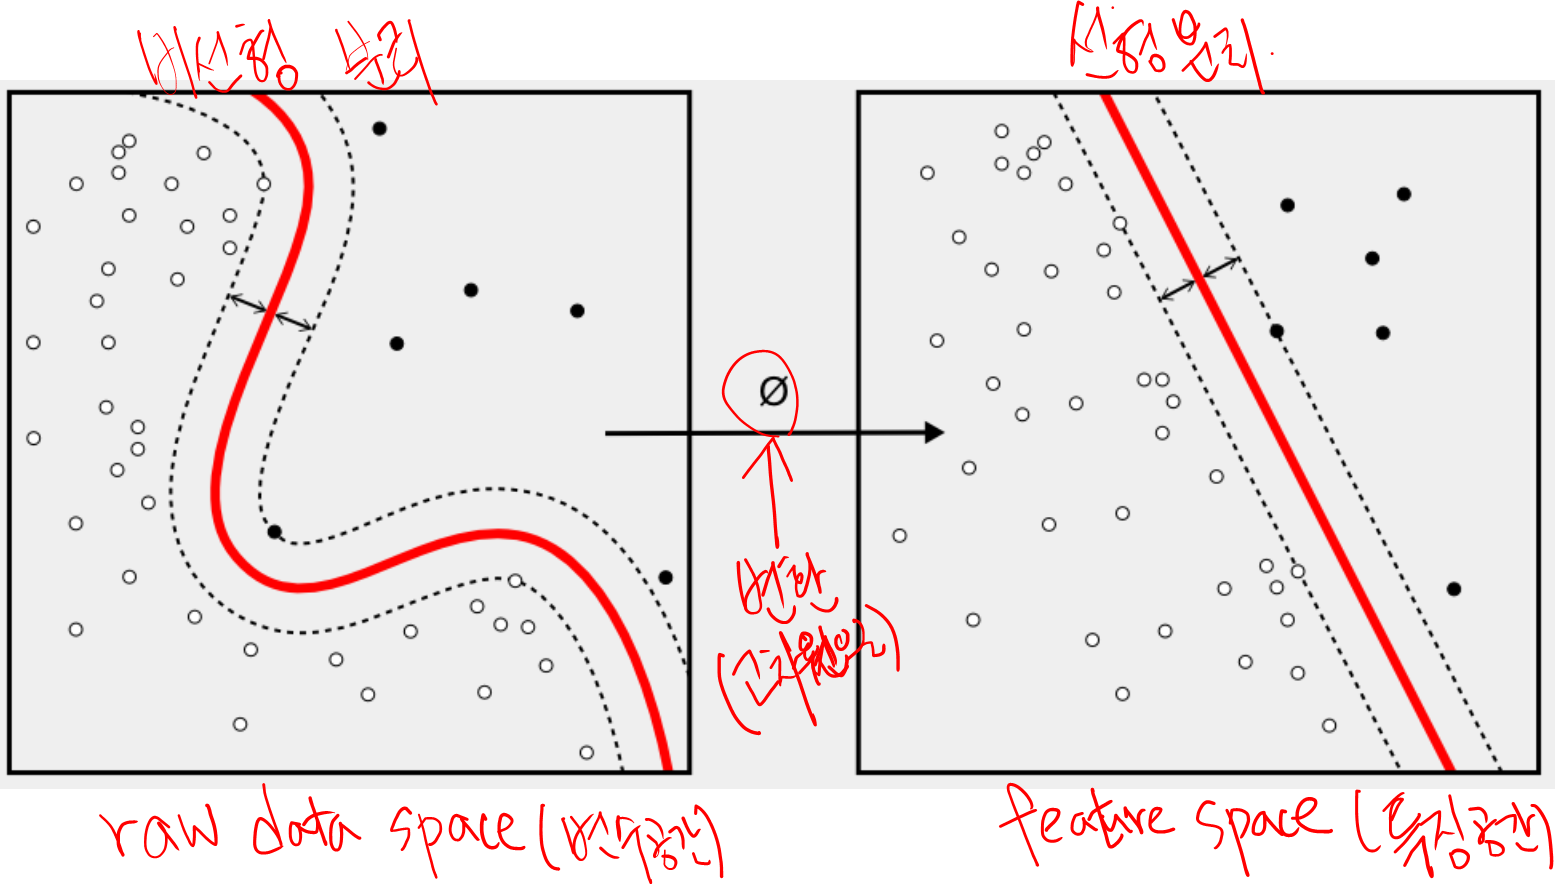
커널을 이용한 고차원 공간으로 변환
4.5 R 예제
4.5.1 R 패키지 및 함수
| R패키지 및 함수명 | 옵션 | 함수/옵션 설명 |
|---|---|---|
| e1071::naiveBayes | laplace | Laplace smoothing(default=0) |
| class::knn | k | 근방 관측치 수 |
| nnet::nnet | size | hidden node의 수 |
| linout | switch for linear output units | |
| entropy | switch for entropy | |
| softmax | switch for softmax | |
| decay | parameter for weight decay(default=0) | |
| maxit | 역전파 알고리즘의 반복 횟수를 지정하며 기본값은 100임 | |
| neuralnet::neuralnet | hidden | |
| err.fct | error function(“sse” | |
| act.fct | activation function(“logistic” | |
| linear.ouout | switch for linear output units | |
| algorithm | learning algorithm(“backprop” | |
| e1071::svm | kernel | “linear” |
| gamma | parameter for kernel function | |
| type | “C-classification” | |
| “nu-classification” | ||
| cost | C constraint(regularized param: defaut=1) | |
| cross | K-fold CV(default=0) | |
| dataset::iris | Edgar Anderson’s Iris Data | |
| ElemStatLearn::spam | spam mail data |
4.5.2 Naive Bayes 예제
모형적합
library(e1071)
iris_cat <- iris
# 입력변수를 범주화 (연속변수를 두개의 그룹으로 범주화)
iris_cat$Sepal.Length <- cut(iris$Sepal.Length, c(-Inf, median(iris$Sepal.Length), Inf))
iris_cat$Sepal.Width <- cut(iris$Sepal.Width, c(-Inf, median(iris$Sepal.Width), Inf))
iris_cat$Petal.Length <- cut(iris$Petal.Length, c(-Inf, median(iris$Petal.Length), Inf))
iris_cat$Petal.Width <- cut(iris$Petal.Width, c(-Inf, median(iris$Petal.Width), Inf))
model <- naiveBayes(Species ~ ., data = iris_cat)
model

## Naive Bayes Classifier for Discrete Predictors
##
## Call:
## naiveBayes.default(x = X, y = Y, laplace = laplace)
##
## A-priori probabilities: (데이터에서 각 클래스별 확률을 추정)
## Y
##     setosa versicolor  virginica
##  0.3333333  0.3333333  0.3333333
##
## Conditional probabilities: (조건부 확률의 추정)
##             Sepal.Length
## Y            (-Inf,5.8] (5.8, Inf]
##   setosa           1.00       0.00
##   versicolor       0.48       0.52
##   virginica        0.12       0.88
##
##             Sepal.Width
## Y            (-Inf,3] (3, Inf]
##   setosa         0.16     0.84
##   versicolor     0.84     0.16
##   virginica      0.66     0.34
##
##             Petal.Length
## Y            (-Inf,4.35] (4.35, Inf]
##   setosa             1.0         0.0
##   versicolor         0.5         0.5
##   virginica          0.0         1.0
##
##             Petal.Width
## Y            (-Inf,1.3] (1.3, Inf]
##   setosa           1.00       0.00
##   versicolor       0.56       0.44
##   virginica        0.00       1.00
예측:
predict()함수로 예측, 기본적으로 타겟의 클래스 레벨을 예측하나, 옵션type="raw"는 클래스 확률을 예측함predict(model, iris_cat[1:5, -5], type = "raw") # class probabilities ## setosa versicolor virginica ## [1,] 0.9750390 0.0249610 4.735903e-08 ## [2,] 0.5863038 0.4136959 2.902204e-07 ## [3,] 0.9750390 0.0249610 4.735903e-08 ## [4,] 0.9750390 0.0249610 4.735903e-08 ## [5,] 0.9750390 0.0249610 4.735903e-08pred <- predict(model, iris_cat) head(pred) ## [1] setosa setosa setosa setosa setosa setosa ## Levels: setosa versicolor virginica모형평가
# Confusion Matrix
table(pred, iris$Species)
## pred         setosa versicolor virginica
##   setosa         50         19         0
##   versicolor      0         13         6
##   virginica       0         18        44
# using laplace smoothing: model2 <- naiveBayes(Species ~ ., data = iris, laplace = 3) pred <- predict(model2, iris[,-5]) table(pred, iris$Species) ## pred setosa versicolor virginica ## setosa 50 0 0 ## versicolor 0 47 3 ## virginica 0 3 47
위에서는 연속형 입력변수를 두 그룹으로 범주화하여 모델링 하였다. 여기서는 4분위수를 이용하여 달리 범주화한 후 나이브베이즈모형에 적합시키자. 먼저 훈련자료와 검증자료를 분리하여 모형을 적합하고 검증자료로 모형을 평가해 보자.
데이터 변환
library(e1071)
# 훈련자료. 검증자료로 data 분할
set.seed(12345) # 랜덤 seed
# 훈련자료의 인덱스 추출(비복원 추출), 추출되지 않은 나머지 자료는 검증자료로 이용
tr.idx <- sample(nrow(iris), nrow(iris)*0.5, replace=F)
head(tr.idx)
## [1] 142  51  58  93  75  96

iris2 <- iris
cut_values <- apply(iris2[, -5], 2, quantile)
# 입력변수를 범주형 변수로 변환 (여기서는 4분위수 이용)
for(i in 1:4) iris2[, i] <- cut(iris2[, i], cut_values[,i])
head(iris2)

##   Sepal.Length Sepal.Width Petal.Length Petal.Width Species
## 1    (4.3,5.1]   (3.3,4.4]      (1,1.6]   (0.1,0.3]  setosa
## 2    (4.3,5.1]     (2.8,3]      (1,1.6]   (0.1,0.3]  setosa
## 3    (4.3,5.1]     (3,3.3]      (1,1.6]   (0.1,0.3]  setosa
## 4    (4.3,5.1]     (3,3.3]      (1,1.6]   (0.1,0.3]  setosa
## 5    (4.3,5.1]   (3.3,4.4]      (1,1.6]   (0.1,0.3]  setosa
## 6    (5.1,5.8]   (3.3,4.4]   (1.6,4.35]   (0.3,1.3]  setosa
모형적합 (Naive Bayes)
model <- naiveBayes(Species ~ ., data = iris2[tr.idx, ])
model
## Naive Bayes Classifier for Discrete Predictors
#
##
## Call:
## naiveBayes.default(x = X, y = Y, laplace = laplace)
##
## A-priori probabilities:
## Y
##     setosa versicolor  virginica
##     0.3733     0.3333     0.2933
##
## Conditional probabilities:
##             Sepal.Length
## Y            (4.3,5.1] (5.1,5.8] (5.8,6.4] (6.4,7.9]
##   setosa       0.70370   0.29630   0.00000   0.00000
##   versicolor   0.12000   0.48000   0.28000   0.12000
##   virginica    0.00000   0.04545   0.36364   0.59091
##
##             Sepal.Width
## Y            (2,2.8] (2.8,3] (3,3.3] (3.3,4.4]
##   setosa      0.0000  0.2143  0.1786    0.6071
##   versicolor  0.6000  0.2800  0.0800    0.0400
##   virginica   0.2727  0.3636  0.2273    0.1364
##
##             Petal.Length
## Y            (1,1.6] (1.6,4.35] (4.35,5.1] (5.1,6.9]
##   setosa     0.96296    0.03704    0.00000   0.00000
##   versicolor 0.00000    0.64000    0.36000   0.00000
##   virginica  0.00000    0.00000    0.22727   0.77273
##
##             Petal.Width
## Y            (0.1,0.3] (0.3,1.3] (1.3,1.8] (1.8,2.5]
##   setosa        0.8333    0.1667    0.0000    0.0000
##   versicolor    0.0000    0.6800    0.3200    0.0000
##   virginica     0.0000    0.0000    0.1818    0.8182
훈련 자료 예측
# predict
# type = "raw"이면 사후확률 추정, 아니면 클래스범주 출력
predict(model, iris2[1:5, -5], type = "raw")
##      setosa versicolor virginica
## [1,]      1  1.250e-08 3.125e-10
## [2,]      1  2.479e-07 2.361e-09
## [3,]      1  8.500e-08 1.771e-09
## [4,]      1  8.500e-08 1.771e-09
## [5,]      1  1.250e-08 3.125e-10
# 검증자료에 대해 예측
pred <- predict(model, iris2[-tr.idx,-5])
##  [1] setosa     versicolor setosa     setosa     setosa
##  [6] setosa     setosa     setosa     versicolor setosa
## [11] setosa     setosa     setosa     setosa     setosa
## Levels: setosa versicolor virginica
검증자료를 이용한 예측 및 모형 평가
- 모형평가: Confusion Matrix & 오분류율 (Misclasification Error rate)
# Confusion Matrix
o <- table(pred, iris2$Species[-tr.idx])
o
## pred         setosa versicolor virginica
##   setosa         20          0         0
##   versicolor      2         18         6
##   virginica       0          7        22
# Misclasification Error rate
1- sum(diag(o))/sum(o)
## [1] 0.2
Laplace smoothing을 적용한 모델링 결과와 모형평가
model2 <- naiveBayes(Species ~ ., data = iris2[tr.idx, ], laplace = 3)
pred2 <- predict(model2, iris2[-tr.idx, -5])
table(pred2, iris2$Species[-tr.idx])
## pred2        setosa versicolor virginica
##   setosa         20          0         0
##   versicolor      2         21        10
##   virginica       0          4        18
4.5.3 k-NN 예제
데이터 준비: knn을 적합하기 위해서
class패키지를 사용한다.library(class) set.seed(1) y <- iris[,5] # Partition indice into training data & test data tr.idx <- sample(length(y), 75)모형적합 및 예측
pred <- knn(train=iris[tr.idx, -5], test=iris[-tr.idx, -5], cl=y[tr.idx], k = 3)
##  [1] setosa     setosa     setosa     setosa     setosa
##  [6] setosa     setosa     setosa     setosa     setosa
## [11] setosa     setosa     setosa     setosa     setosa
## Levels: setosa versicolor virginica
모형 평가
table(pred, y[-tr.idx])
## pred         setosa versicolor virginica
##   setosa         22          0         0
##   versicolor      0         30         2
##   virginica       0          0        21
4.5.4 neural network 예제: nnet
fit
library(nnet)
ir1 <- nnet(Species~., data=iris[tr.idx,], size = 2, decay = 5e-4)
summary(ir1)
## a 4-2-3 network with 19 weights
## options were - softmax modelling  decay=5e-04
##  b->h1 i1->h1 i2->h1 i3->h1 i4->h1
##   0.66  -1.33  -0.13   1.88   1.51
##  b->h2 i1->h2 i2->h2 i3->h2 i4->h2
##   7.63  -0.11   1.31  -1.04  -2.77
##  b->o1 h1->o1 h2->o1
##  -3.20 -14.05  14.82
##  b->o2 h1->o2 h2->o2
##  -1.74   1.40   5.08
##  b->o3 h1->o3 h2->o3
##   4.85  12.44 -19.94
predict
pred <- predict(ir1, iris[-tr.idx, -5], type = "class")모형 평가 : confusion matrix
table(iris$Species[-tr.idx], pred)

##           pred
##            setosa versicolor virginica
## setosa         22          0         0
## versicolor      0         30         0
## virginica       0          2        21
4.5.5 Support Vector Machine : Spam Data
data: spam 데이터는
ElemStatLearn패키지에 내장되어 있다.#install.packages("ElemStatLearn") data(spam, package = "ElemStatLearn") str(spam) ### 'data.frame': 4601 obs. of 58 variables: ### $ A.1 : num 0 0.21 0.06 0 0 0 0 0 0.15 0.06 ... ### $ A.2 : num 0.64 0.28 0 0 0 0 0 0 0 0.12 ... ### ... ### $ A.57: int 278 1028 2259 191 191 54 112 49 1257 749 ... ### $ spam: Factor w/ 2 levels "email","spam": 2 2 2 2 2 2 2 2 2 2 ...SVM 모형은 조율모수(tuning parameter)가 있어서, 먼저 tune()함수를 이용하여 조율모수의 최적값을 탐색한다.
# sampling index of train data
tr.idx <- sample(nrow(spam), 0.7*nrow(spam))
# tunning parameters
# tuning
obj <- tune(svm, spam ~ ., data = spam[tr.idx,],
           ranges = list(cost = c(0.25, 0.35)))
summary(obj)
## Parameter tuning of ‘svm’:
##
## - sampling method: 10-fold cross validation
##
## - best parameters:
##  cost
##  0.35
##
## - best performance: 0.07826
##
## - Detailed performance results:
##   cost   error dispersion
## 1 0.25 0.08043   0.007670
## 2 0.35 0.07826   0.005238
탐색된 최적의 조율모수를 이용하여 SVM 모형을 적합한다.
# fit svm model
model <- svm(spam ~., data = spam[tr.idx,], cost=obj$best.parameters$cost)
summary(model) # coefs
## Call:
## svm(formula = spam ~ ., data = spam[tr.idx, ], cost = obj$best.parameters$cost)
##
##
## Parameters:
##    SVM-Type:  C-classification
##  SVM-Kernel:  radial
##        cost:  0.35
##
## Number of Support Vectors:  1159
##
##  ( 596 563 )
##
##
## Number of Classes:  2
##
## Levels:
##  email spam
prediction & performance evaluation
pred <- predict(model, newdata=spam[-tr.idx,])
table(spam$spam[-tr.idx], pred)
##      pred
##       email spam
## email   822   36
## spam     77  446