제 8 장 연관규칙의 탐색
8.1 연관규칙분석이란
- 연관규칙분석은 비지도학습법의 일종으로 자료에 있는 항목(item)들간의 연관규칙을 찾는 방법 - 항목은 상품, 서비스 등을 의미함
- 마케팅에서는 고객의 장바구니에 들어있는 품목간의 관계를 알아본다는 의미에서 장바구니분석(market basket analysis)이라고도 부름
- 활용
- 효율적인 상품의 진열
- 패키지 상품의 개발
- 교차판매 전략
- 기획상품의 결정
8.2 연관규칙분석의 적용 사례
- 백화점, 호텔 등 서비스업에서는 연관규칙을 통하여 고객들이 특정 서비스를 받은 후 다음에 어떤 서비스를 원하는지 미리 알 수 있고,
- 신용카드사나 은행에서는 고객들의 기존 금융서비스 내역으로부터 대출과 같은 특정한 서비스를 받을 가능성이 높은 고객을 찾을 수 있다.
- 의료보험이나 손해보험에서는 고객의 보험금 청구가 기존의 정상적인 청구와 다른 패턴을 보이는 경우 보험사기의 징조로 간주하여 추가적인 조사를 하게 된다.
- 인터넷 쇼핑몰에서 상품의 추천
- 텍스트마이닝에서 연관 키워드 또는 유사 문서의 추출
- 웹사이트의 접속자의 페이지간의 이동
8.3 연관규칙의 생성방법 예시
예제 데이터
거래번호 품목 1 오렌지쥬스,사이다 2 우유, 오렌지쥬스, 식기세척제 3 오렌지쥬스, 세제 4 오렌지쥬스, 세제, 사이다 5 식기 세척제, 사이다 동시구매표
오렌지쥬스 식기세척제 우유 사이다 세제 오렌지쥬스 4 1 1 2 2 식기세척제 1 2 1 1 0 우유 1 1 1 0 0 사이다 2 1 0 3 1 세제 2 0 0 1 2
8.4 연관규칙분석의 측도
연관규칙: \(X \Rightarrow Y\) (\(X\)이면 \(Y\)이다)
연관규칙 측도: 연관규칙의 유용성 또는 선택을 위한 측도
지지도(support): 품목 \(X\)의 지지도는 전체 거래에서 \(X\)를 포함한 거래 비율로 정의 \[ \text{지지도}(X) = P(X) = \frac{ \text{X가 포함된 거래수}}{\text{전체 거래수}} \]
신뢰도(confidence): \(X\)를 구입한 거래 중 \(Y\)를 같이 구입한 비율 \[ \text{지지도}(X \Rightarrow Y) = P(Y | X) = \frac{P(X, Y)}{P(Y)} = \frac{\text{품목 X와 Y를 동시에 포함하는 거래수}}{\text{품목 X를 포함하는 거래수}} \]
향상도(lift): \(X \Rightarrow Y\)의 신뢰도와 \(Y\)의 지지도의 비율, 즉 \(X\)를 구매했을 때 \(Y\)의 구매 비율이 그러한 조건이 없는 경우에 비해 얼마나 커지는가를 나타내는 지표 \[ \text{향상도}(X \Rightarrow Y) = \frac{P(Y | X)}{P(Y)} = \frac{conf(X \Rightarrow Y)}{supp(Y)} \]
예제: 앞에 제시된 데이터에서 연관규칙을 계산하면 아래와 같다.
지지도(support)
- supp(오렌지쥬스) = 4/5
- supp(사이다) = 3/5
- supp(식기세척제) = 2/5
- supp(세제) = 2/5
- supp(오렌지쥬스, 사이다) = 2/5
- supp(오렌지쥬스, 세제) = 2/5
신뢰도(confidence): \(X\)를 구입한 거래 중 \(Y\)를 같이 구입한 비율
- conf(오렌지쥬스 => 사이다) = (2/5)/(2/5) = 1
- conf(사이다 => 오렌지쥬스) = (2/5)/(3/5) = 2/3
향상도(lift): \(X\)를 구매했을 때 \(Y\)의 구매 비율이 그러한 조건이 없는 경우에 비해 얼마나 커지는가?
- lift(오렌지쥬스 => 사이다) = 1/(3/5) = 5/3 > 1
- lift(사이다 => 오렌지쥬스) = (2/3)/(4/5) = 5/6 < 1
8.5 R을 이용한 연관 규칙의 탐색 예제
8.5.1 Epub data
- 2003년 1월부터 2008년 12월까지의 전자문서의 다운로드 이력 (Vienna University of Economics and Business Administration)
- 총 936 item에 대한 다운로드 트랜젝션의 수는 15,729 건
- 이 내장 데이터는
transaction / itemMatrix클래스로 3개의 컬럼으로 구성되어 있음
# install.packages("arules")
library(arules)
data("Epub")
inspect(head(Epub))

##     items                      transactionID TimeStamp
## [1] {doc_154}                  session_4795  2003-01-02 10:59:00
## [2] {doc_3d6}                  session_4797  2003-01-02 21:46:01
## [3] {doc_16f}                  session_479a  2003-01-03 00:50:38
## [4] {doc_11d, doc_1a7, doc_f4} session_47b7  2003-01-03 08:55:50
## [5] {doc_83}                   session_47bb  2003-01-03 11:27:44
## [6] {doc_11d} session_47c2 2003-01-04 00:18:04summary(Epub)
## transactions as itemMatrix in sparse format with
## 15729 rows (elements/itemsets/transactions) and
## 936 columns (items) and a density of 0.001758755
##
## most frequent items:
## doc_11d doc_813 doc_4c6 doc_955 doc_698 (Other)
## 356 329 288 282 245 24393
##
## element (itemset/transaction) length distribution:
## sizes
## 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21
## 11615 2189 854 409 198 121 93 50 42 34 26 12 10 10 6 8 6 5 8 2 2
## 22 23 24 25 26 27 28 30 34 36 38 41 43 52 58
## 3 2 3 4 5 1 1 1 2 1 2 1 1 1 1
##
## Min. 1st Qu. Median Mean 3rd Qu. Max.
## 1.000 1.000 1.000 1.646 2.000 58.000
##
## includes extended item information - examples:
## labels
## 1 doc_11d
## 2 doc_13d
## 3 doc_14c
##
## includes extended transaction information - examples:
## transactionID TimeStamp
## 10792 session_4795 2003-01-02 10:59:00
## 10793 session_4797 2003-01-02 21:46:01
## 10794 session_479a 2003-01-03 00:50:38year = strftime(as.POSIXlt(transactionInfo(Epub)[["TimeStamp"]]), "%Y")
# 지지도가 0.01이상의 상위 20개의 아이템들에 대한 다운로드 수(absolute) 상대빈도(relative)
itemFrequencyPlot(Epub[year == "2003"], type="absolute", topN=20, support=0.01)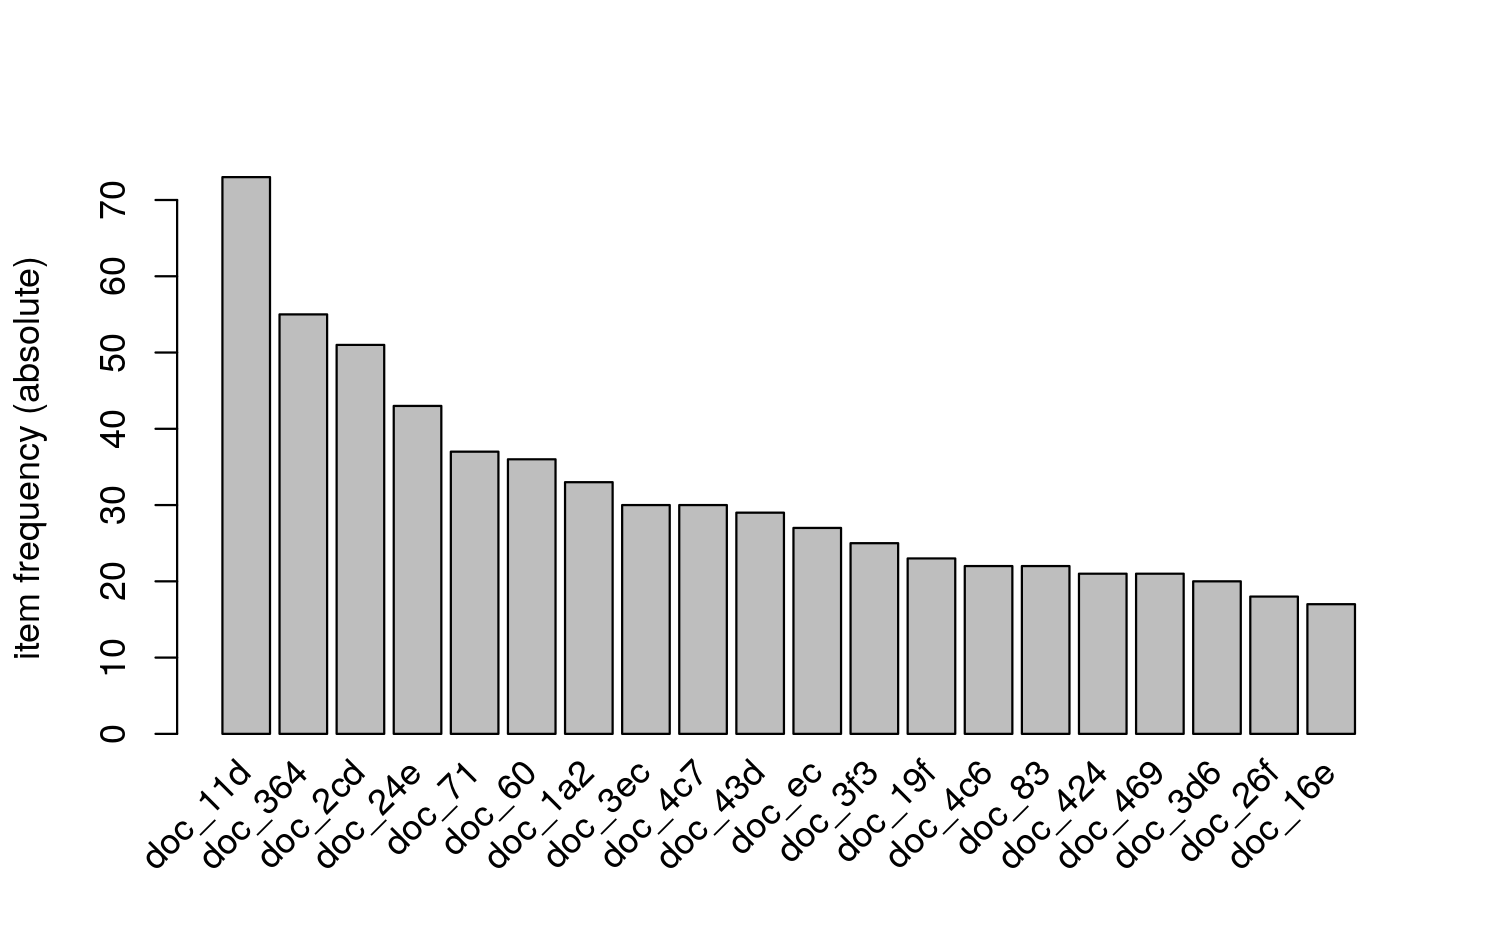
# 연관 규칙 탐색 (support >= 0.001)
Epub_rules = apriori(Epub,
                      parameter = list(support = 0.001))
inspect(Epub_rules)

##     lhs                   rhs       support     confidence coverage    lift     count
## [1] {doc_6e8, doc_6e9} => {doc_6e7} 0.001080806 0.8947368  0.001207960 402.0947 17
## [2] {doc_6e7, doc_6e9} => {doc_6e8} 0.001080806 0.8500000  0.001271537 417.8016 17
## [3] {doc_6e7, doc_6e8} => {doc_6e9} 0.001080806 0.8095238  0.001335113 454.7500 17
8.5.2 Adult 자료
데이터:
Adult자료 : 미국 Census Bureau의 Census Income 데이터베이스에서 추출된 설문조사 자료 48,842개의 관측값과 나이, 직업군, 교육정도 등의 15개의 변수(대부분의 변수들이 범주형) 지지도, 신뢰도, 향상도 등이 주어진 적절한 최소값보다 큰 연관규칙을 탐색해 보자
먼저, R패키지를 설치하고 내장데이터를 살펴보자
library(arules) # adult data data(Adult)apriori()함수: 주어진 데이터에서 미리 정해진 연관성 측도를 만족하는 연관규칙들을 탐색apriori(데이터, parameter = list(supp = 0.5, conf = 0.9, target = "rules")) # parameter는 연관성측도의 최소값을 지정하여 리스트로 입력 # supp = 0.5(지지도), conf = 0.9(신뢰도), target = "rules"지지도 (support) >= 0.5 이고 신뢰도 (confidence) >= 0.9 인 연관규칙의 탐색
rules <- apriori(Adult, parameter = list(supp = 0.5, conf = 0.9, target = "rules"))
summary(rules)

## set of 52 rules
##
## rule length distribution (lhs + rhs):sizes
##  1  2  3  4
##  2 13 24 13
##
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##   1.000   2.000   3.000   2.923   3.250   4.000
##
## summary of quality measures:
##     support         confidence        coverage           lift            count
##  Min.   :0.5084   Min.   :0.9031   Min.   :0.5406   Min.   :0.9844   Min.   :24832
##  1st Qu.:0.5415   1st Qu.:0.9155   1st Qu.:0.5875   1st Qu.:0.9937   1st Qu.:26447
##  Median :0.5974   Median :0.9229   Median :0.6293   Median :0.9997   Median :29178
##  Mean   :0.6436   Mean   :0.9308   Mean   :0.6915   Mean   :1.0036   Mean   :31433
##  3rd Qu.:0.7426   3rd Qu.:0.9494   3rd Qu.:0.7945   3rd Qu.:1.0057   3rd Qu.:36269
##  Max.   :0.9533   Max.   :0.9583   Max.   :1.0000   Max.   :1.0586   Max.   :46560
##
#
## mining info:
##   data ntransactions support confidence                                                                              call
##  Adult         48842     0.5        0.9 apriori(data = Adult, parameter = list(supp = 0.5, conf = 0.9, target = "rules"))
’sex -> ?’인 연관성 규칙에서 향상도가 1보다 큰 규칙의 탐색
rules.sub = subset(rules, subset = lhs %pin% "sex" & lift > 1)
inspect(sort(rules.sub)[1:3])

##     lhs                                          rhs                            support   confidence coverage  lift     count
## [1] {race=White, sex=Male}                    => {native-country=United-States} 0.5415421 0.9204803  0.5883256 1.025691 26450
## [2] {sex=Male, native-country=United-States}  => {race=White}                   0.5415421 0.9051090  0.5983170 1.058554 26450
## [3] {race=White, sex=Male, capital-loss=None} => {native-country=United-States} 0.5113632 0.9190124  0.5564268 1.024056 24976