제 3 장 기계학습
기계학습 (머신러닝, Machine Learning): AI의 일종 또는 AI와 일부 중첩되는 분야로 데이터를 이용한 자동화 컴퓨터 알고리즘을 연구하는 분야임
기계학습 알고리즘은 훈련 데이터를 기반으로 모형을 만들고 그 모형을 이용하여 예측하거나 의사결정에 활용할 수 있도록 함, 대표적인 활용 예로는 스팸메일 판별, 음성인식, 컴퓨터 비전등이 있음
기계학습은 아래와 같이 데이터의 특징과 목적에 따라 분류할 수 있음
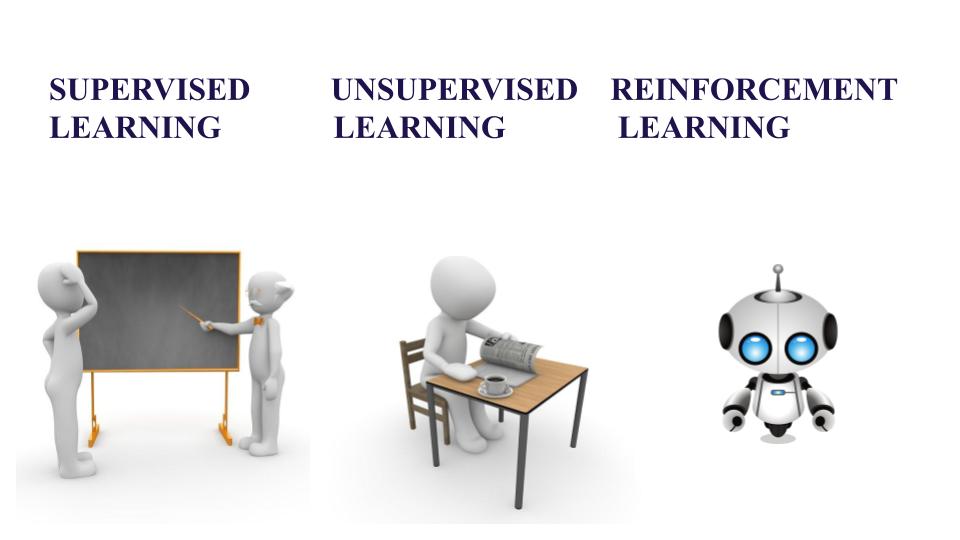
- 감독학습(지도학습, supervised learning): 입력변수와 출력변수의 함수관계를 학습
- 회귀문제 (Regression problem): 반응값이 수치형인 경우
- 분류문제 (Classification problem): 반응값이 범주형인 경우
- 비감독학습 (비지도학습, 자율학습, unsupervised learning): 출력변수가 없이 입력변수들만 이용하여 학습
- 차원축소: 다차원(변수) 데이터를 저차원 데이터로 변환
- 확률분포의 추정, 이상치 탐색
- 군집분석: 데이터의 패턴의 유사성을 이용하여 그룹화
- 연관성분석: 변수들간 또는 변수의 속성값들간의 연관성 분석
- 강화학습 (Reinforcement Learning): 과거 데이터를 학습하는 것이 아니라 현재 상태에서 시행착오 혹은 시뮬레이션에 의해 최적의 행동을 결정함. 시행착오 경험에 의해 행동을 점차 개선시킴.
- 현재의 데이터 (혹은 Experience)를 학습하여 어떤 Action을 취하고 결과에 대해 보상 (Reward)을 받음.
- 보상은 결과에 따라 양수 (+ : Reward) 일 수도 있고 음수 (- : Punishment)일 수도 있음.
- 강화학습은 보상이 최대가 되는 Action을 찾는 방법임.
- 감독학습(지도학습, supervised learning): 입력변수와 출력변수의 함수관계를 학습
3.1 감독학습의 종류
- 일반화선형모형
- 선형회귀, 로지스틱회귀
- 벌점이 있는 모형
- ridge - \(l_2\) penalty
- lasso - \(l_1\) penalty
- elastic net - \(l_1+l_2\) penalty
- 비모수 모형 / 비선형 모형
- 의사결정나무, knn, 인공신경망
- ensembles
- bagging
- boosting
- random forest
3.2 예측 모델링 절차
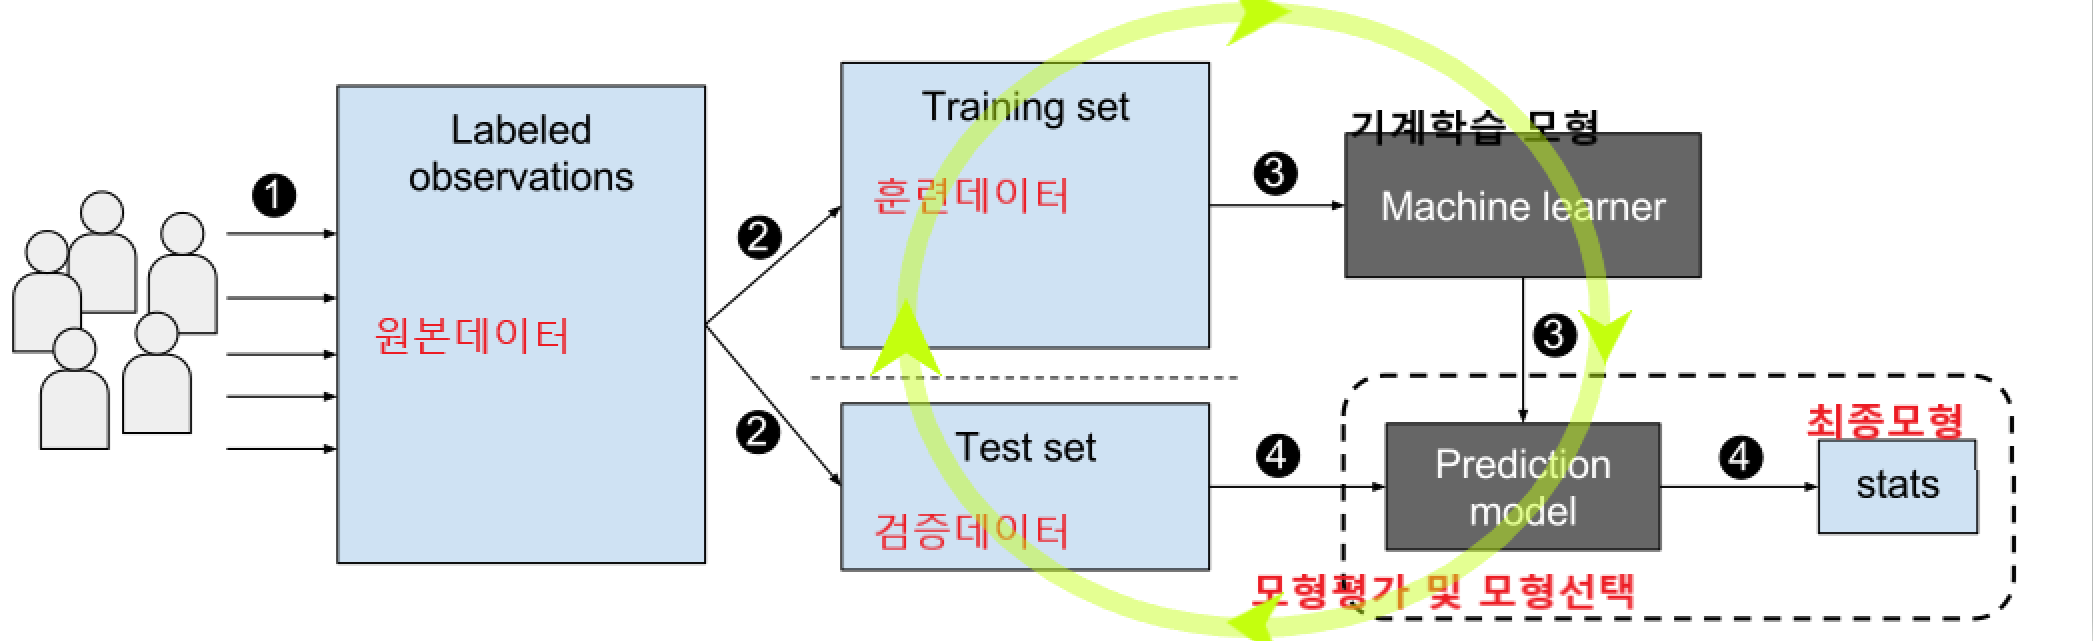
기계학습 절차
- 데이터 준비 및 분할
- 모형의 적합 및 평가 (반복)
- 훈련자료 (train data)를 이용한 모형적합
- 검증자료 (Test data)에 의한 모형평가
- 모형의 해석 및 예측
3.3 모형의 평가
3.3.1 모형 평가의 측도
회귀모형의 평가측도
- 예측평균오차제곱(Prediction Mean Squared Error, PMSE) \(E(Y-\hat Y)^2\)
분류모형의 평가 측도
- 오분류율 (Error rate) (\(E(Y \ne \hat Y)\))
- 오분류표 (confusion matrix)
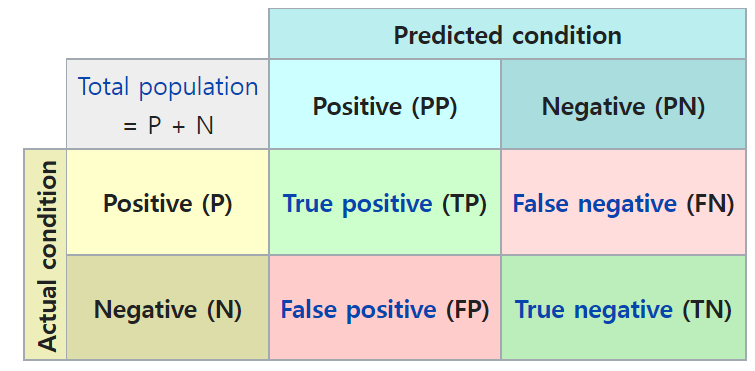
| Actural | True(1) | False(0) |
|---|---|---|
| Positive (1) | True Positive (TP) | False Negative (FN) |
| Negative (0) | False Positive (FP) | True Negative (TN) |
- 오분류율 (Error rate)
- 검증 데이터에서 실제값 (\(y\))과 모형에 의한 예측값(\(\hat y\))이 서로 다른 자료의 비율 \[P(\hat{Y} \ne Y) = \frac{TP+TN}{TP+FN+FP+TN}\]
- 재현율(recall)
- 진양성율(TPR, true positive rate), 민감도(sensitivity)이라고도 하며, 실제값이 양성(Positive)인 자료 중에서 모형의 예측값 역시 양성으로 예측한 비율 \[\mathrm{recall} = P(\hat{Y} = 1 | Y = 1) = \frac{TP}{TP+FN}\]
- 위양성율 (FPR, false positive rate)
- 실제값이 음성(negative)인 자료 중에서 예측모형이 양성(positive)으로 예측한 비율 \[ \mathrm{FPR} = \frac{\mathrm{FP}}{\mathrm{FP+TN}} = 1 - \mathrm{specificity} \]
- 정확률 (Precision)
- 양성(positive)으로 예측한 자료 중에서 실제값이 양성(positive)인 비율 \[P(Y = 1 | \hat{Y} = 1)= \frac{\mathrm{TP}}{\mathrm{TP+FP}}\]
- 특이도 (Specificity)
- 실제값이 음성(negative)인 자료 중에서 예측모형이 음성(negative)으로 예측한 비율 \[P(\hat{Y} = 0 | Y = 0)= \frac{\mathrm{TN}}{\mathrm{FP+TN}}\]
- F1 score
- recall과 precision의 조화평균 \[ F1 = \left(\frac{\frac{1}{\mathrm{prec}} + \frac{1}{\mathrm{recall} }}{2}\right)^{-1} = 2\times \frac{\mathrm{prec} \times \mathrm{recall}}{\mathrm{prec} + \mathrm{ recall}} \]
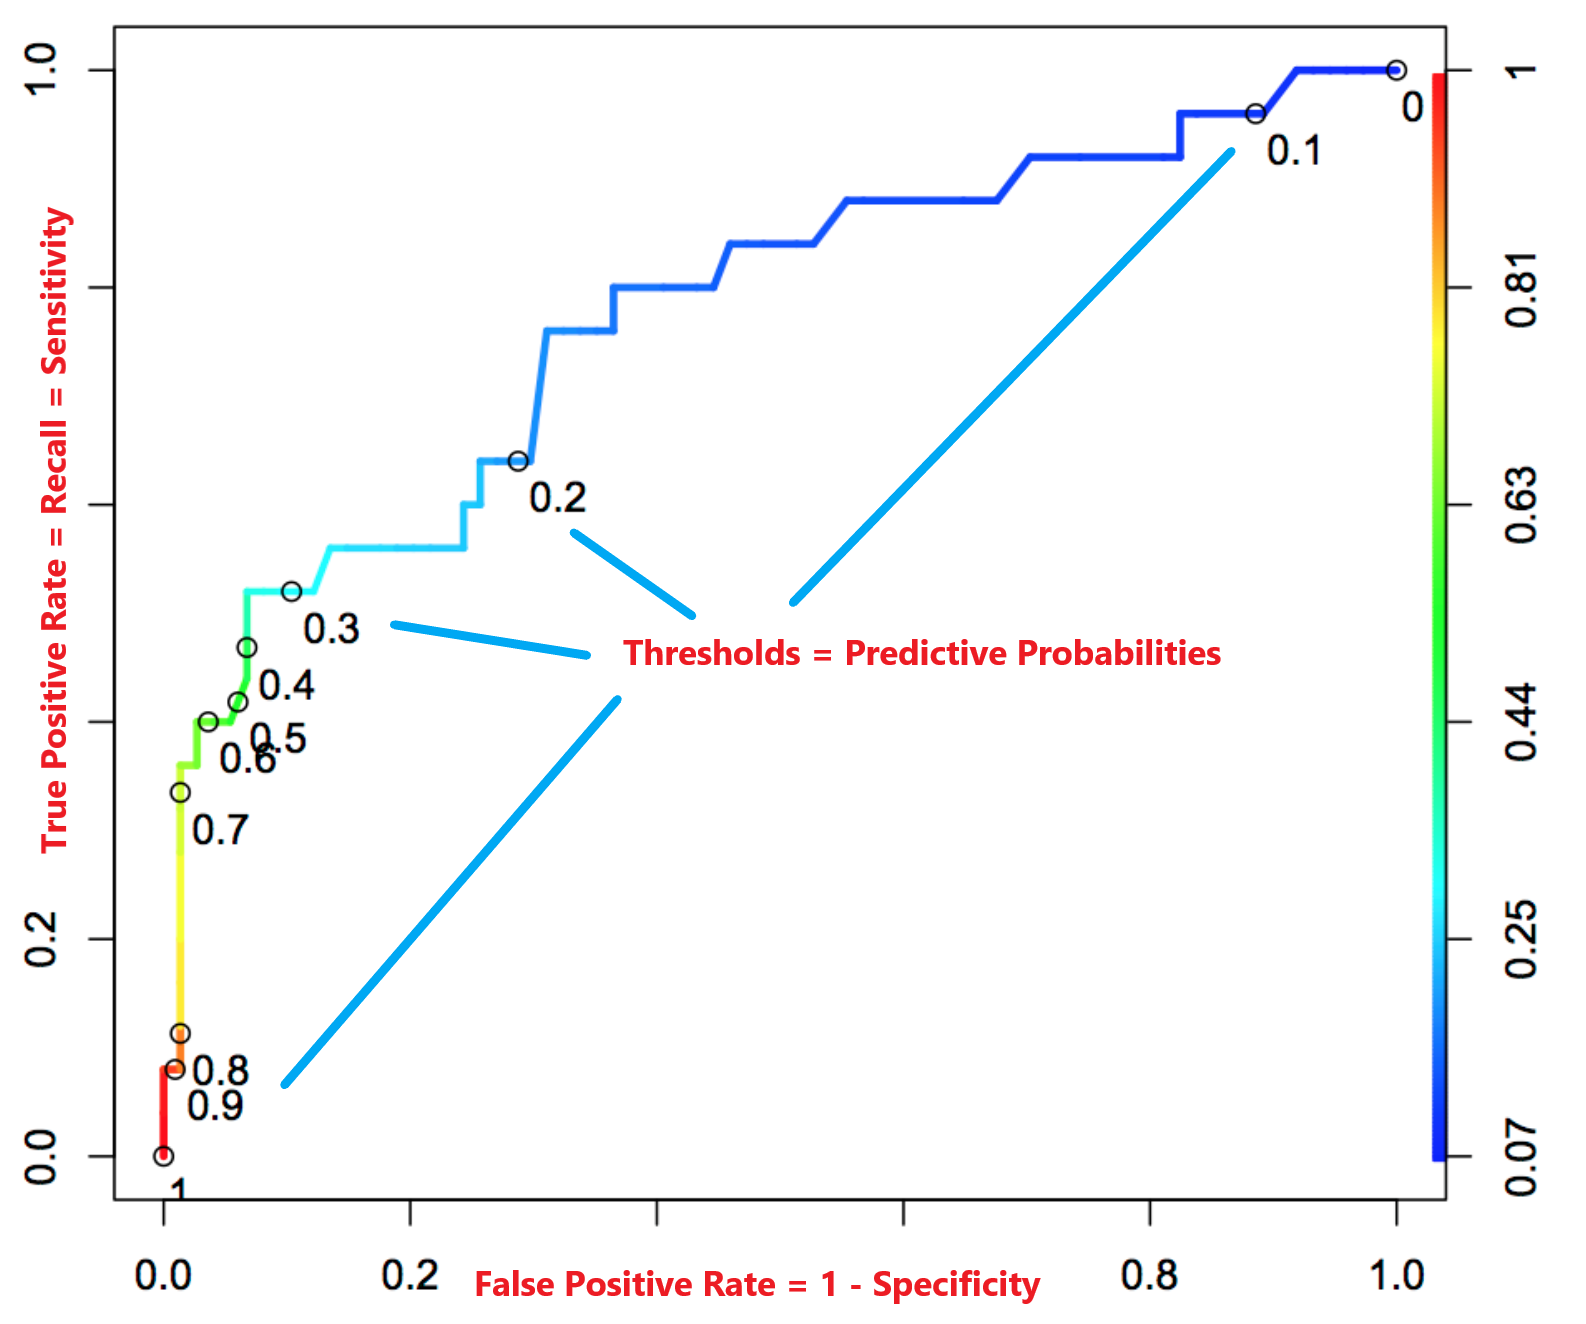
- ROC curve(Receiver operating characteristic)
- 분류모형은 양성일 확률을 예측할 수 있으며, 예측한 확률이 적정 임계값(threshold)보다 크면 양성으로, 아니면 음성으로 판단함. 이 경우 확률의 임계값에 따라 예측(판정)값이 달라질 수 있음. ROC는 확률 임계값의 변화에 따른 모형의 민감도(sensitivity)와 (1 - 특이도)를 도표화한 것이며, 하여 모형의 예측정확도를 평가하는 방법
- AUC(Area under the curve)
- ROC curve의 아래 부분의 면적
3.3.2 검증오차 (Test error)
- 자료(데이터)를 훈련자료(\(\mathcal{L}\))와 검증자료(\(\mathcal{T}\))로 분할
- 훈련자료를 이용 예측모형 \(\hat{f}_k(), k=1, ..., M\)를 적합
- 검증자료를 이용해 검증오차 계산 \[ E_k = \sum_{(x_i, y_i) \in \mathcal{T}} l( \hat{f}_k( {x}_i), y_i)/m\]
- 모든 모형들에 대해 검증오차를 계산하고 그 중 최소가 되는 모형을 선택
- 검증오차법은 주어진 데이터의 갯수가 충분히 많은 경우에 사용
3.3.3 교차확인법 (cross validation; CV)
- 교차확인법은 검증오차법의 일반화
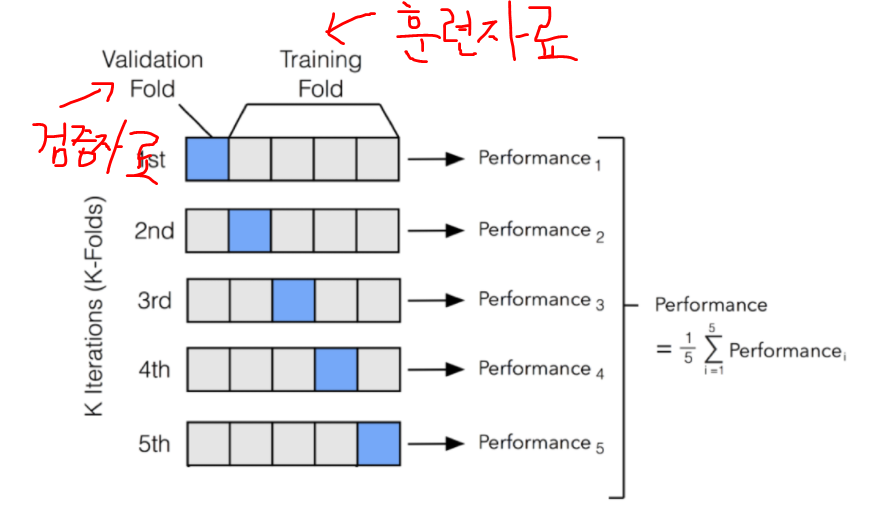
- 자료를 서로 배반(disjoint)이 되도록 무작위로 \(K\)개의 묶음(fold)들 \(\mathcal{L}_1, \cdots , \mathcal{L}_K\)로 분할
- \(k=1,\ldots,K\)에 대하여 \(\bigcup_{l\neq k} \mathcal{L}_l\)을 이용하여 \(\hat{f}_k({x})\)를 구하고
- \(\mathcal{L}_k\)를 검증자료로 사용하여 검증오차를 구함
- \(K\)개의 검증오차의 산술평균을 \(K\)-묶음 교차확인오차(k-fold cross validation)
- 각 모형들에 대한 교차확인오차를 계산하고 그 값이 최소가 되는 모형을 선택
- 1-표준편차 규칙(1-standard deviation rule): 교차확인오차의 분산이 큰 경우, 최소값을 가지는 모형 근방(흔히 표준편차의 범위내에서)에서 가장 단순한 모형을 찾는 방법
3.4 예측모형을 위한 R패키지 및 절차별 R 함수
모형 적합
예측모형 R패키지 R함수 선형회귀모형,일반화선형회귀 stats lm, glm ridge glmnet glmnet lasso glmnet glmnet kNN class knn 인공신경망 nnet 의사결정나무 rpart bagging bagging boosting gbm random forest randomForest 모형 결과의 요약 정리
print,plot,summary예측
predict(fit, newdata)모형 평가
ROCR, ‘caret’ packages
3.5 회귀분석 예제
3.5.1 난방비 데이터
먼저 데이터를 살펴보자,
rd <- read.csv("data/난방비.csv", header=T)
dim(rd)
## [1] 20  5

head(rd, 3)

##   난방비 외부온도 단열재두께 창문수 아파트나이
## 1    252     1.65          3     10          6
## 2    382    -1.65          4      1         10
## 3 167 2.20 7 9 3 - 모형적합
  gfit <- lm(난방비~.,data=rd)
  gfit

## Call:
## lm(formula = 난방비 ~ ., data = rd)
##
## Coefficients:
## (Intercept)     외부온도   단열재두께       창문수   아파트나이
## 294.46 -8.44 -14.91 -1.17 6.26 - 추정 모형 결과
summary(gfit)
## Call:
## lm(formula = 난방비 ~ ., data = rd)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -79.22 -36.60  -1.55  28.34  87.48
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept)   294.46      64.62    4.56  0.00038 ***
## 외부온도       -8.44       1.55   -5.44  6.9e-05 ***
## 단열재두께    -14.91       5.31   -2.81  0.01321 *
## 창문수         -1.17       5.11   -0.23  0.82282
## 아파트나이      6.26       4.31    1.45  0.16684
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## Residual standard error: 54.4 on 15 degrees of freedom
## Multiple R-squared:  0.798,  Adjusted R-squared:  0.744
## F-statistic: 14.8 on 4 and 15 DF,  p-value: 4.38e-05
3.5.2 Boston housing data
- 데이터
library(MASS)
dim(Boston) # [1] 506  14

head(Boston, 5)

##      crim zn indus chas   nox    rm  age   dis rad tax ptratio black lstat medv
## 1 0.00632 18  2.31    0 0.538 6.575 65.2 4.090   1 296    15.3 396.9  4.98 24.0
## 2 0.02731  0  7.07    0 0.469 6.421 78.9 4.967   2 242    17.8 396.9  9.14 21.6
## 3 0.02729  0  7.07    0 0.469 7.185 61.1 4.967   2 242    17.8 392.8  4.03 34.7
## 4 0.03237  0  2.18    0 0.458 6.998 45.8 6.062   3 222    18.7 394.6  2.94 33.4
## 5 0.06905  0  2.18    0 0.458 7.147 54.2 6.062   3 222    18.7 396.9  5.33 36.2
변수 설명
variables description crim 지역의 범죄율 zn 25,000 sq.ft.당 주거지 비율 indus 비소매사업의 면적비율 chas Charles강유역 여부, dummy nox 질소 산화물 농도 rm 주택 당 평균 방의 수 age 1940년 이전에 건설된 자가 주택 비율 dis 5개의 보스턴 고용 센터까지의 평균 거리 rad 고속도로 접근성 지수 tax 1만 달러당 재산세율 ptratio 학생당 교사비율 black \(1000(\text{흑인비율}- 0.63)^2\) lstat 저소득층 비율 medv 자가소유 주택 가격의 중앙값 탐색적자료분석 (EDA)
par(mfrow=c(2,3))
plot(Boston$crim, Boston$medv)
plot(Boston$zn, Boston$medv)
plot(Boston$indus, Boston$medv)
boxplot(medv~chas, data=Boston)
plot(Boston$age, Boston$medv)
plot(Boston$dis, Boston$medv)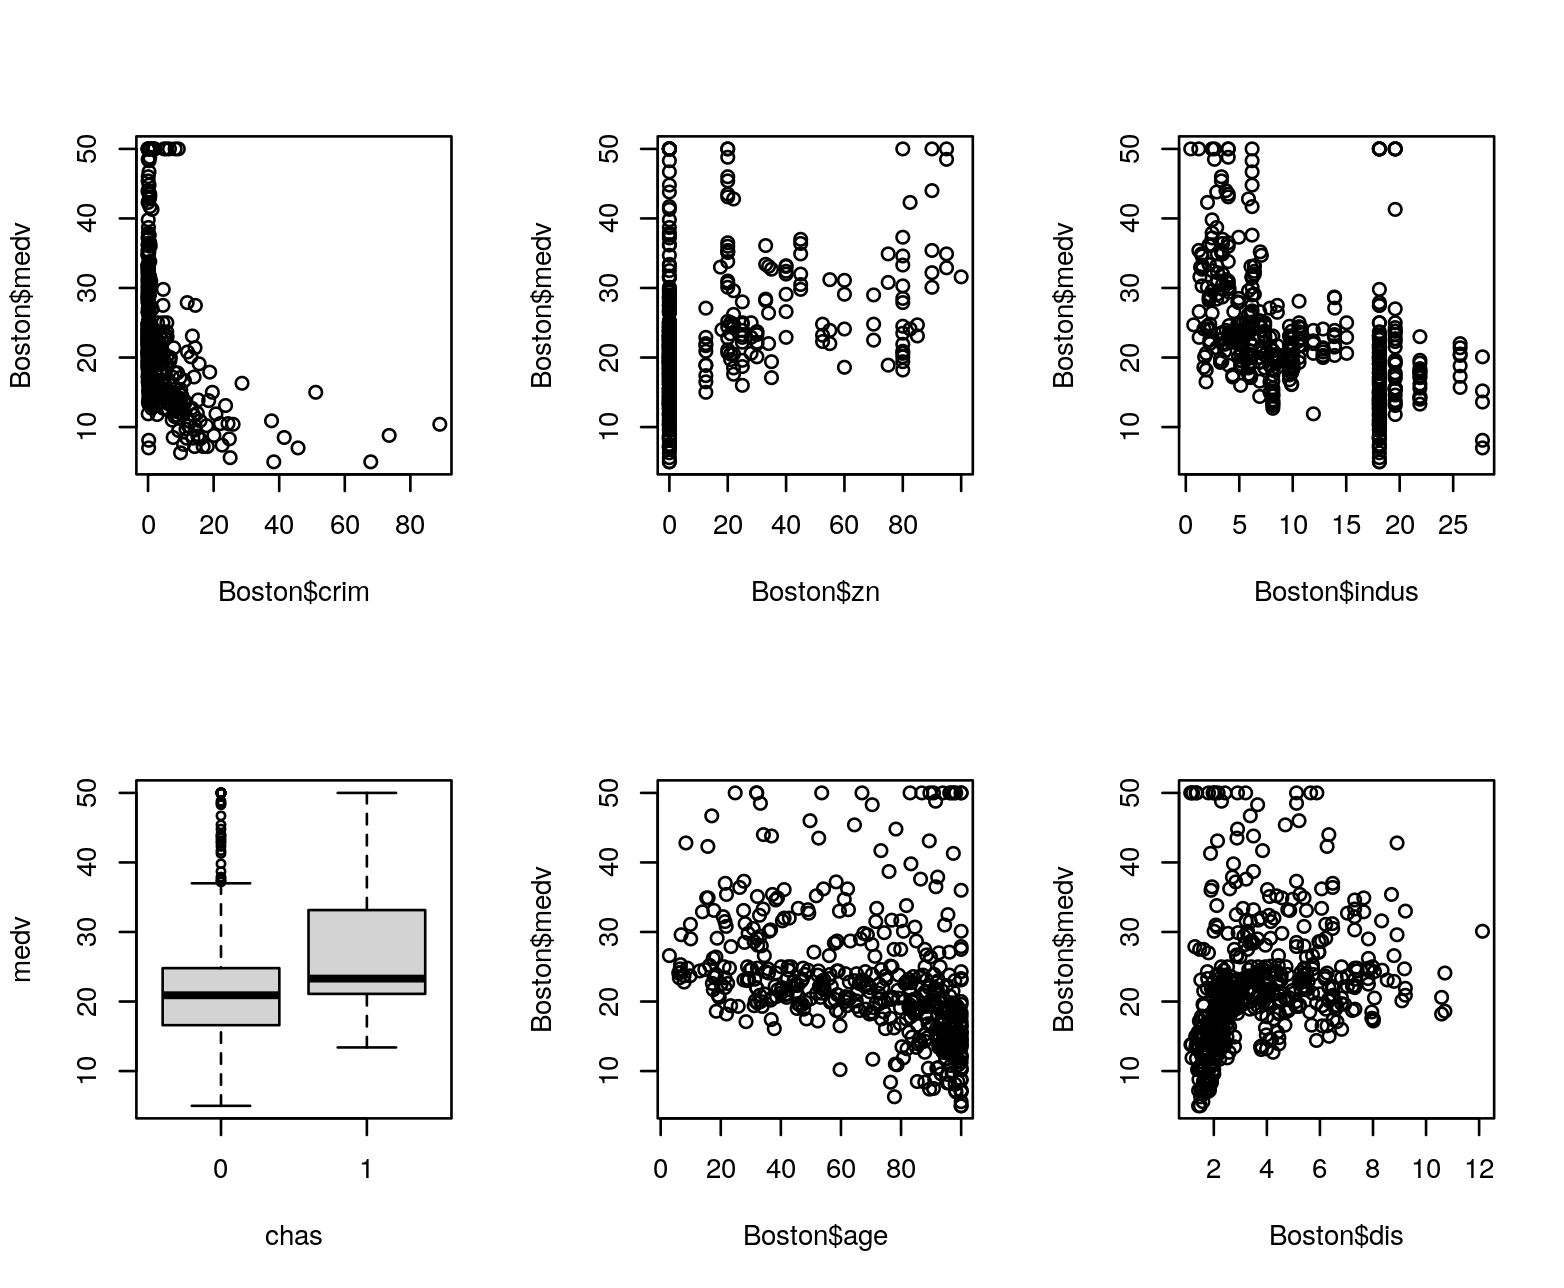
모형적합
  lm.fit <- lm(medv~.,data=Boston)
  summary(lm.fit)

## Coefficients:
##               Estimate Std. Error t value Pr(>|t|)
## (Intercept)  3.646e+01  5.103e+00   7.144 3.28e-12 ***
## crim        -1.080e-01  3.286e-02  -3.287 0.001087 **
## zn           4.642e-02  1.373e-02   3.382 0.000778 ***
## indus        2.056e-02  6.150e-02   0.334 0.738288
## chas         2.687e+00  8.616e-01   3.118 0.001925 **
## nox         -1.777e+01  3.820e+00  -4.651 4.25e-06 ***
## rm           3.810e+00  4.179e-01   9.116  < 2e-16 ***
## age          6.922e-04  1.321e-02   0.052 0.958229
## dis         -1.476e+00  1.995e-01  -7.398 6.01e-13 ***
## rad          3.060e-01  6.635e-02   4.613 5.07e-06 ***
## tax         -1.233e-02  3.760e-03  -3.280 0.001112 **
## ptratio     -9.527e-01  1.308e-01  -7.283 1.31e-12 ***
## black        9.312e-03  2.686e-03   3.467 0.000573 ***
## lstat       -5.248e-01  5.072e-02 -10.347  < 2e-16 ***
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

## Residual standard error: 4.745 on 492 degrees of freedom
## Multiple R-squared:  0.7406,  Adjusted R-squared:  0.7338
## F-statistic: 108.1 on 13 and 492 DF,  p-value: < 2.2e-16
모형 갱신(업데이트)
# model update
lm.fit1 <- update(lm.fit, ~.-indus-age)
summary(lm.fit1)

## Coefficients:
#
##              Estimate Std. Error t value Pr(>|t|)
## (Intercept)  36.34115    5.06749    7.17  2.7e-12 ***
## crim         -0.10841    0.03278   -3.31  0.00101 **
## zn            0.04584    0.01352    3.39  0.00075 ***
## chas          2.71872    0.85424    3.18  0.00155 **
## nox         -17.37602    3.53524   -4.92  1.2e-06 ***
## rm            3.80158    0.40632    9.36  < 2e-16 ***
## dis          -1.49271    0.18573   -8.04  6.8e-15 ***
## rad           0.29961    0.06340    4.73  3.0e-06 ***
## tax          -0.01178    0.00337   -3.49  0.00052 ***
## ptratio      -0.94652    0.12907   -7.33  9.2e-13 ***
## black         0.00929    0.00267    3.47  0.00056 ***
## lstat        -0.52255    0.04742  -11.02  < 2e-16 ***
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## Residual standard error: 4.74 on 494 degrees of freedom
## Multiple R-squared:  0.741,  Adjusted R-squared:  0.735
## F-statistic:  128 on 11 and 494 DF,  p-value: <2e-16
3.6 로지스틱 분석 예제
UniversalBank 자료의 분석
3.6.1 UniversalBank 데이터
loan <- read.csv("data/UniversalBank.csv")

names(loan)
##  [1] "ID"                "Age"               "Experience"        "Income"            "ZIP.Code"
##  [6] "Family"            "CCAvg"             "Education"         "Mortgage"          "PersonalLoan"
## [11] "SecuritiesAccount" "CDAccount"         "Online"            "CreditCard"

dim(loan)
##[1] 5000   14

loan[1:3,]
##   ID Age Experience Income ZIP.Code Family CCAvg Education Mortgage PersonalLoan SecuritiesAccount
## 1  1  25          1     49    91107      4   1.6         1        0            0                 1
## 2  2  45         19     34    90089      3   1.5         1        0            0                 1
## 3  3  39         15     11    94720      1   1.0         1        0            0                 0
##   CDAccount Online CreditCard
## 1         0      0          0
## 2         0      0          0
## 3         0      0          0
3.6.2 자료 탐색
반응변수 (PersonalLoan)와 입력변수들과의 관계를 교차표를 이용하여 살펴봄
library(dplyr)
loan =  tibble(loan)

# 변수의 범주형 변환
loan = loan %>%
  select(!ID) %>%
  mutate(Education = factor(Education),
         ZIP.Code = factor(substr(as.character(loan$ZIP.Code), 1,2)),
         PersonalLoan  = factor(PersonalLoan),
         SecuritiesAccount = factor(SecuritiesAccount),
         CDAccount = factor(CDAccount),
         Online = factor(Online),
         CreditCard = factor(CreditCard)
         )

summary(loan)

 ##      Age         Experience       Income        ZIP.Code             Family        CCAvg
 ## Min.   :23.0   Min.   :-3.0   Min.   :  8.0   Length:5000        Min.   :1.0   Min.   : 0.00
 ## 1st Qu.:35.0   1st Qu.:10.0   1st Qu.: 39.0   Class :character   1st Qu.:1.0   1st Qu.: 0.70
 ## Median :45.0   Median :20.0   Median : 64.0   Mode  :character   Median :2.0   Median : 1.50
 ## Mean   :45.3   Mean   :20.1   Mean   : 73.8                      Mean   :2.4   Mean   : 1.94
 ## 3rd Qu.:55.0   3rd Qu.:30.0   3rd Qu.: 98.0                      3rd Qu.:3.0   3rd Qu.: 2.50
 ## Max.   :67.0   Max.   :43.0   Max.   :224.0                      Max.   :4.0   Max.   :10.00
 ## Education    Mortgage     PersonalLoan SecuritiesAccount CDAccount Online   CreditCard
 ## 1:2096    Min.   :  0.0   0:4520       0:4478            0:4698    0:2016   0:3530
 ## 2:1403    1st Qu.:  0.0   1: 480       1: 522            1: 302    1:2984   1:1470
 ## 3:1501    Median :  0.0
 ##           Mean   : 56.5
 ##           3rd Qu.:101.0
 ##           Max.   :635.0
# binary: PersonalLoan, SecuritiesAccount, CDAccount, Online, CreditCard
t1 <- table(PersonalLoan=loan$PersonalLoan, CreditCard=loan$CreditCard)
##             CreditCard
## PersonalLoan    0    1
##            0 3193 1327
##            1  337  143

prop.table(t1, 1)
##             CreditCard
## PersonalLoan      0      1
##            0 0.7064 0.2936
##            1 0.7021 0.2979
반응변수 (PersonalLoan)와 입력변수들과의 t검정, 카이제곱 검정 입력변수가 수치형(연속형)이면 t검정, 범주형이면 카이제곱 검정
y_var = "PersonalLoan"
x_vars = setdiff(names(loan), y_var)

p = lapply(x_vars, function(v){
  if(class(loan[[v]]) == "factor"){
    p = chisq.test(table(y=loan$PersonalLoan, x=loan[[v]]))$p.value
    v = "factor"
  }else{
    p = t.test(loan[[v]] ~ loan$PersonalLoan)$p.value
    v = "numeric"
  }
  data.frame(v, p)
})

p = do.call(rbind, p)
p = data.frame(Var = x_vars, p)

knitr::kable(p, col.names = c("Variable", "Type", "p-value"))| Variable | Type | p-value |
|---|---|---|
| Age | numeric | 0.5888297 |
| Experience | numeric | 0.6036157 |
| Income | numeric | 0.0000000 |
| ZIP.Code | factor | 0.9963936 |
| Family | numeric | 0.0000102 |
| CCAvg | numeric | 0.0000000 |
| Education | factor | 0.0000000 |
| Mortgage | numeric | 0.0000000 |
| SecuritiesAccount | factor | 0.1405150 |
| CDAccount | factor | 0.0000000 |
| Online | factor | 0.6928600 |
| CreditCard | factor | 0.8843861 |
3.6.3 훈련자료 및 검증자료의 준비
loan자료를 분할
# 전체자료의 수
(nsample <- nrow(loan))
## [1] 5000

# 자료의 분할 : tr.idx는 훈련자료의 번호(인덱스)
#             : 전체 자료의 인덱스에서 tr.idx를 제외하면 검증자료가 됨
set.seed(1234)
tr.idx <- sample(nsample, 2500, replace=F)
3.6.4 모형 적합
로지스틱회귀모형은
glm()함수를 이용glm(formula, data, family="binomial")
fit <- glm(PersonalLoan~.-ID, data=loan, subset=tr.idx, family="binomial")
summary(fit)

## Coefficients:
##                     Estimate Std. Error z value Pr(>|z|)
## (Intercept)       -1.424e+01  2.708e+00  -5.259 1.45e-07 ***
## Age                1.829e-02  9.878e-02   0.185 0.853138
## Experience        -1.512e-02  9.797e-02  -0.154 0.877324
## Income             6.450e-02  4.632e-03  13.925  < 2e-16 ***
## Family             6.645e-01  1.160e-01   5.728 1.02e-08 ***
## CCAvg              1.466e-01  6.633e-02   2.209 0.027142 *
## Education2         4.148e+00  4.074e-01  10.182  < 2e-16 ***
## Education3         4.230e+00  3.978e-01  10.634  < 2e-16 ***
## Mortgage           1.812e-03  8.815e-04   2.056 0.039783 *
## SecuritiesAccount -1.088e+00  4.451e-01  -2.443 0.014549 *
## CDAccount          3.728e+00  5.395e-01   6.909 4.87e-12 ***
## Online            -8.387e-01  2.428e-01  -3.455 0.000551 ***
## CreditCard        -1.327e+00  3.429e-01  -3.869 0.000109 ***
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## (Dispersion parameter for binomial family taken to be 1)
##
##     Null deviance: 1512.69  on 2499  degrees of freedom
## Residual deviance:  540.77  on 2487  degrees of freedom
## AIC: 566.77
##
## Number of Fisher Scoring iterations: 8
3.6.5 변수선택
단계적 선택법은
step()함수를 이용
fit2 <- step(fit)

summary(fit2)

## Coefficients:
##                     Estimate Std. Error z value Pr(>|z|)
## (Intercept)       -1.371e+01  8.823e-01 -15.536  < 2e-16 ***
## Income             6.446e-02  4.608e-03  13.987  < 2e-16 ***
## Family             6.646e-01  1.161e-01   5.726 1.03e-08 ***
## CCAvg              1.438e-01  6.563e-02   2.192 0.028413 *
## Education2         4.148e+00  4.070e-01  10.191  < 2e-16 ***
## Education3         4.234e+00  3.944e-01  10.734  < 2e-16 ***
## Mortgage           1.815e-03  8.762e-04   2.072 0.038296 *
## SecuritiesAccount -1.084e+00  4.434e-01  -2.446 0.014463 *
## CDAccount          3.729e+00  5.390e-01   6.920 4.53e-12 ***
## Online            -8.373e-01  2.427e-01  -3.450 0.000561 ***
## CreditCard        -1.334e+00  3.425e-01  -3.895 9.82e-05 ***
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## (Dispersion parameter for binomial family taken to be 1)
##
##     Null deviance: 1512.69  on 2499  degrees of freedom
## Residual deviance:  540.89  on 2489  degrees of freedom
## AIC: 562.89
##
## Number of Fisher Scoring iterations: 8
3.6.6 검증자료를 이용한 예측 및 모형 평가
confusion matrix (오분류표)
Predicted(\(\hat{y}\)) true(\(\hat{y}=1\)) false(\(\hat{y}=0\)) Actural(\(y\)) positive (1) True Positive (TP) False Negative (FN) (type II error) negative (0) False Positive (FP) True Negative (TN) (Type I error) True positive rate(진양성율), Recall(재현율), Sensitivity(민감도): \(P(\hat{Y} = + | Y = +)\)
Error rate(오분류율): \(P(\hat{Y} \ne Y)\)
Precision (정확률): \(P(Y = + | \hat{Y} = +)\)
False positive rate(위양성율), Specificity (특이도) : \(P(\hat{Y} = - | Y = -)\)
민감도(sensitivity)와 특이도(specificity)
- 민감도(sensitivity) - 질병에 걸린 환자 중에서, 진단 결과가 양성으로 나올 확률
- 특이도(specificity) - 질병에 걸리지 않은 환자 중, 진단 결과가 양성으로 나올 확률
ROC curve(Receiver operating characteristic): 분류모형의 확률예측값의 임계값에 따른 예측 판정값에 대하여 민감도(sensitivity)와 (1 - 특이도)를 도표화하여 모형의 예측정확도를 평가하는 방법
AUC(Area under the curve): ROC curve의 아래 부분의 면적
예측 및 오분류표 -
predict(fit, newdata, type=c("link", "response", "terms"))
pred <- predict(fit2, newdata=loan[-tr.idx,], type="response")
(t1 <- table(y=loan$PersonalLoan[-tr.idx], pred=pred>0.5))
##    pred
## y   FALSE TRUE
##   0  2233   17
##   1    90  160

(err <- 1- sum(diag(t1))/sum(t1))
## [1] 0.0428
3.6.7 모형 평가
여기서는
ROCR패키지를 이용하여 ROC 곡선과 AUC를 계산하고 이를 이용하여 모형을 평가한다.
library(ROCR)prediction(predicted, y)performance(pred, measure, x.measure)- “tpr” = “rec” = “sens”: \(P(\hat{Y} = + | Y = +)\)
- “fpr”: \(P(\hat{Y} = + | Y = -)\)
- “err”: \(P(\hat{Y} != Y)\)
- “prec”: \(P(Y = + | \hat{Y} = +)\)
- “spec”=“tnr” : \(P(\hat{Y} = - | Y = -)\)
plot()
ROC: “fpr”(1-spec) vs “tpr”(sens)
AUC: area under the ROC curve
Plot ROC
library(ROCR)
p <- prediction(pred, loan$PersonalLoan[-tr.idx])
perf <- performance(p, measure = "tpr", x.measure = "fpr")
plot(perf, main="ROC of logistic model")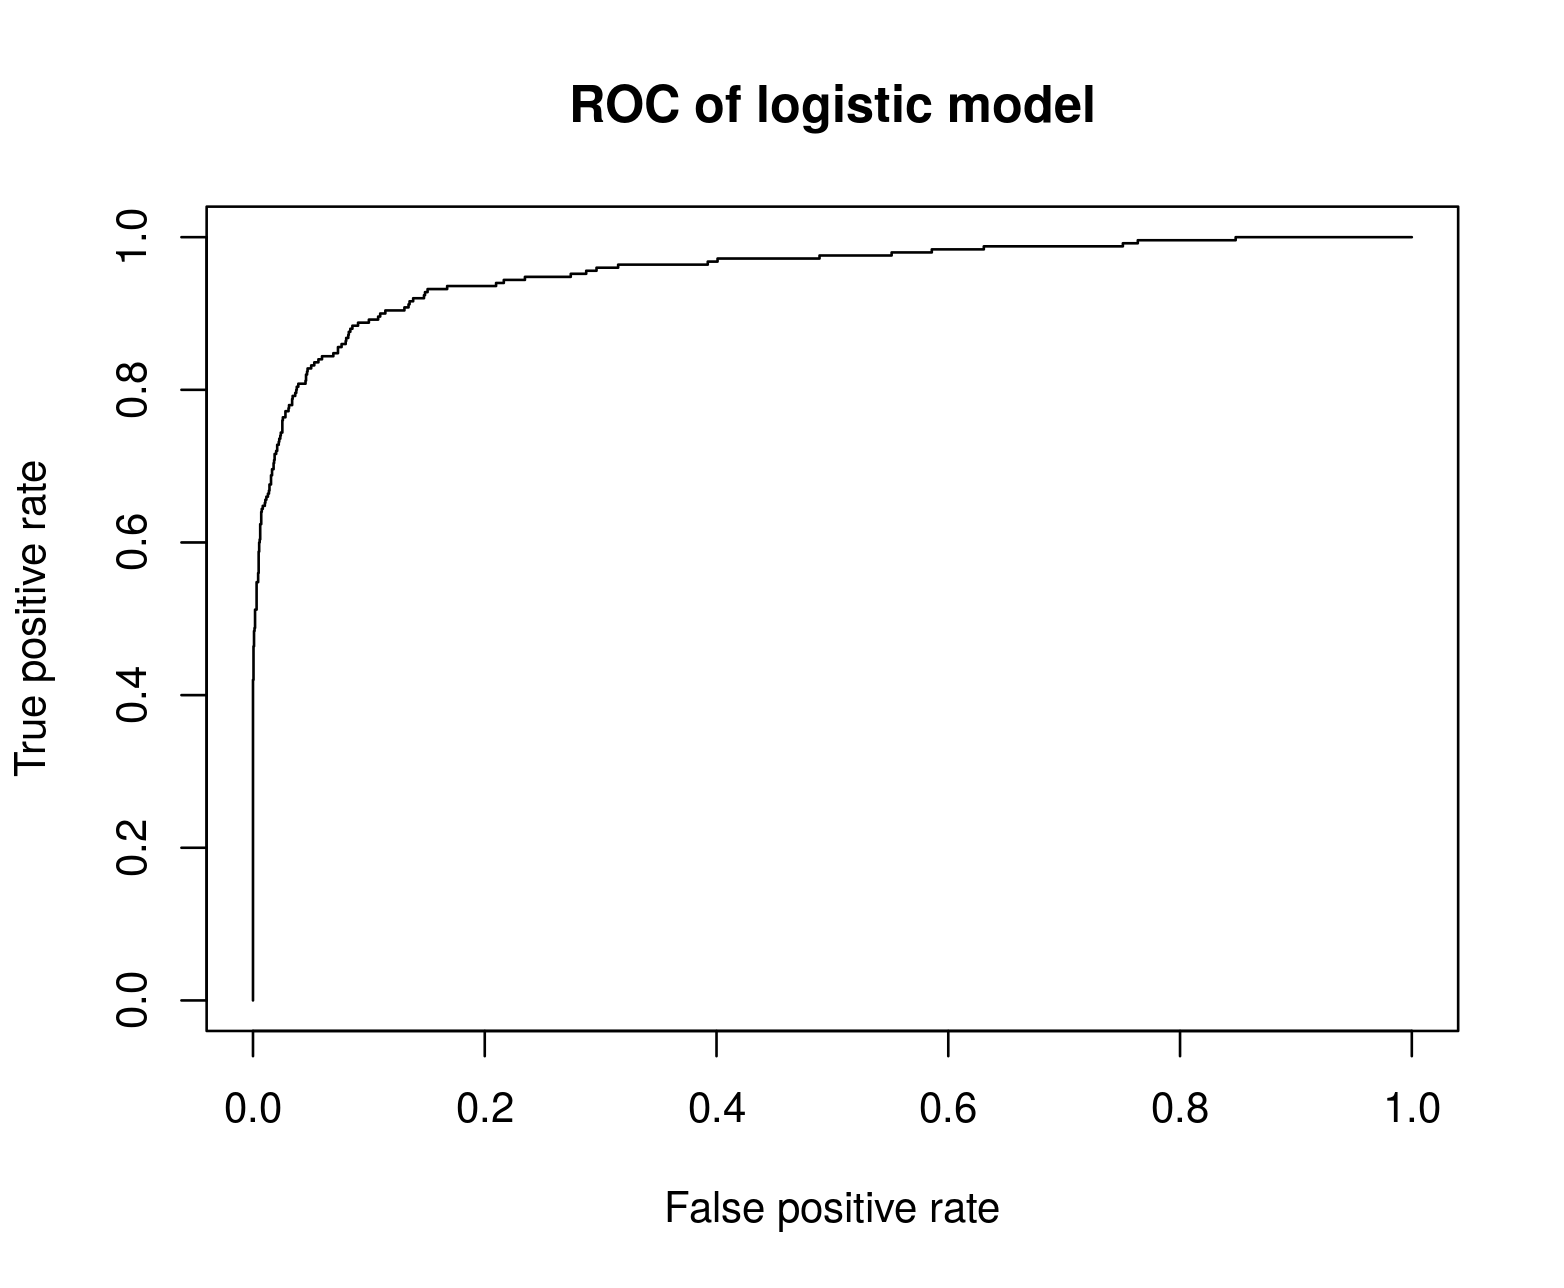
Plot ROC curve and add AUC (Area Under the Curve)
plot(perf, colorize=TRUE, print.cutoffs.at=seq(0,1,by=0.1), text.adj=c(-0.2,1.7))
abline(0,1)
auc = as.numeric(performance(p, "auc")@y.values)
text(0.5, 1, paste("AUC:",round(auc,4)))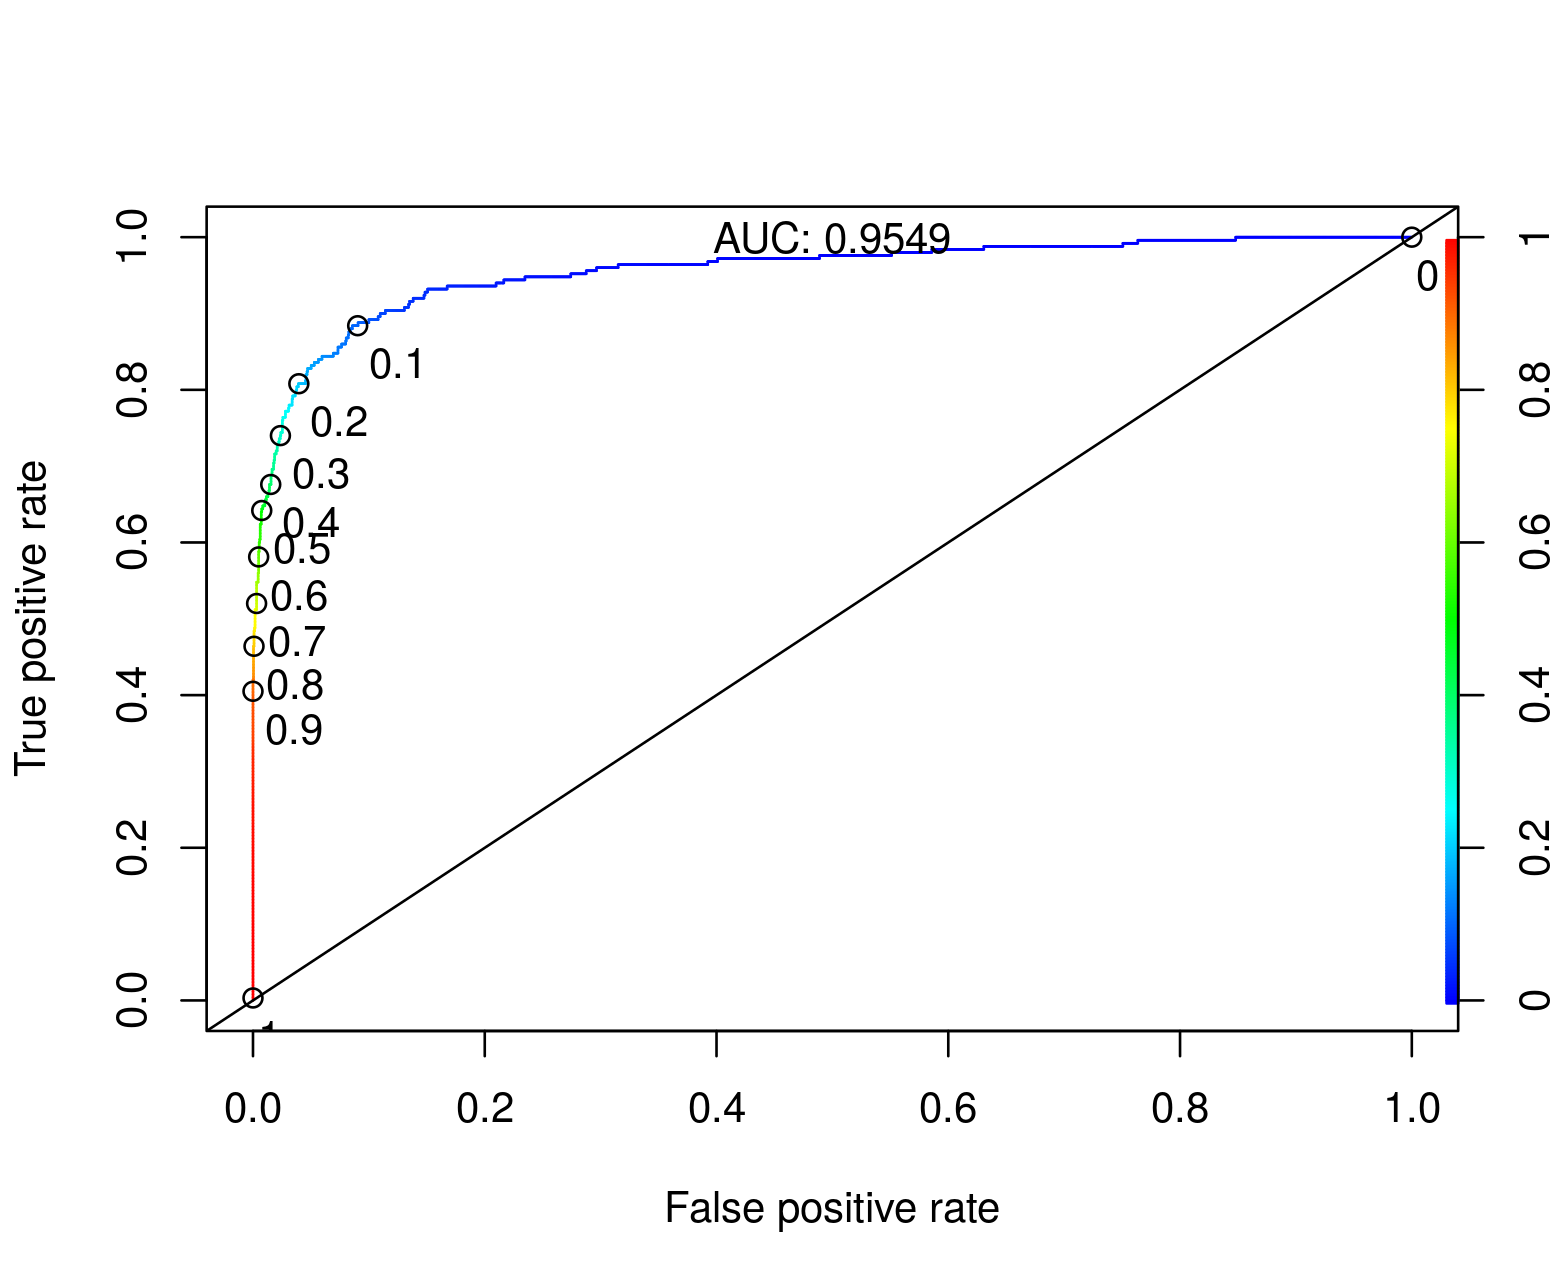
3.7 벌점화 방법
통상적인 선형모형(선형회귀 또는 로지스틱회귀 모형)을 추정할 경우, 아래의 목적함수를 최소로 하는 회귀계수를 찾는 최소제곱법(OLS) 또는 최대가능도추정법(maximum likelihood method)을 사용함, 이 경우 목적함수는 회귀모형에서는 잔차제곱합, 로지스틱회귀모형은 음의 로그가능도함수(negative log-likelihood)가 됨
\[ l(\beta_0, \beta_1, ..., \beta_p)= \frac{1}{n}\sum_{i=1}^{n}\left(y_i-\sum_{j=1}^p \beta_j x_{ij}\right)^2, \]
이와 대조적으로 벌점화 방법의 목적함수는 OLS의 목적함수에 회귀계수의 함수로 구성된 벌점항(\(\sum_{j=1}^{p} J_{\lambda}(\beta_j)\))을 추가하여 아래와 같은 형태를 띰
\[ \frac{1}{n}\sum_{i=1}^{n}\left(y_i-\sum_{j=1}^p \beta_j x_{ij}\right)^2 + \sum_{j=1}^{p} J_{\lambda}(\beta_j) \]
벌점화 방법에서 주로 사용하는 벌점항은 다음과 같은 종류가 있음
- L2-norm: \(J_{\lambda}(z)=\lambda |z|^2\)
- L1-norm(LASSO, Tibshirani, 1996): \(J_{\lambda}(z)=\lambda |z|\)
- LASSO (least absolute shinkage and selection operator)
- elastic net(Zou, 2005): \(\lambda\sum_{j=1}^{p}\left((1-\alpha)|\beta_j| + \alpha \beta_j^2\right), \alpha\in [0,1].\)
위의 벌점항 이외에 다양한 벌점방법들이 제안되어 있음
- group lasso(Yuan et al, Kim et al.)
- fused lasso, SCAD, MCP,…
벌점항이 포함된 목적함수를 이용하여 모형을 추정하는 방법을 regularization 이라고 함
LASSO, ridge, elastic net방법을 통합하여 적용할 수 있도록 하는 R패키지로
glmnet이 있는데 이 패키지는 coordinate descent 알고리즘을 개량한 fast algorithm을 적용하였음 (Friedman, 2010)
아래는 elastic net의 패널티 항으로 \(0\le \alpha\le 1\)사이의 값을 취할 수 있으며 그룹화된 입력변수들이 있는 경우 유용하게 적용할 수 있음
\[ \lambda \sum_{i=1}^p \left(\alpha \beta_j^2 + (1-\alpha) |\beta_j|\right) \]
elastic net에서 패널티 항의 \(\alpha=0\)으로 두면 lasso 이고, \(\alpha=1\)으로 두면 ridge가 됨
3.7.1 R 패키지 및 함수
glmnet 함수명 |
옵션 | 옵션 설명 |
|---|---|---|
| glmnet | ||
| x,y | input, output | |
| family | binomial,gaussian,poisson,cox | |
| lambda | penalty1 | |
| alpha | penalty2: [0,1] | |
| cv.glmnet | k-fold CV for lambda | |
| plot.glmnet | ||
| plot.cv.glmnet | ||
| predict | prediction |
3.7.2 벌점화 방법 예제
spam 데이터 분석
3.7.2.1 데이터
library(ElemStatLearn)
spam = tibble::tibble(spam)

spam
### A tibble: 6 × 58
##     A.1   A.2   A.3   A.4   A.5   A.6   A.7   A.8   A.9  A.10  A.11  A.12  A.13  A.14  A.15  A.16  A.17
##   <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
## 1  0     0.64  0.64     0  0.32  0     0     0     0     0     0     0.64  0     0     0     0.32  0
## 2  0.21  0.28  0.5      0  0.14  0.28  0.21  0.07  0     0.94  0.21  0.79  0.65  0.21  0.14  0.14  0.07
## 3  0.06  0     0.71     0  1.23  0.19  0.19  0.12  0.64  0.25  0.38  0.45  0.12  0     1.75  0.06  0.06
## 4  0     0     0        0  0.63  0     0.31  0.63  0.31  0.63  0.31  0.31  0.31  0     0     0.31  0
## 5  0     0     0        0  0.63  0     0.31  0.63  0.31  0.63  0.31  0.31  0.31  0     0     0.31  0
## 6  0     0     0        0  1.85  0     0     1.85  0     0     0     0     0     0     0     0     0
### … with 41 more variables: A.18 <dbl>, A.19 <dbl>, A.20 <dbl>, A.21 <dbl>, A.22 <dbl>, A.23 <dbl>,
###   A.24 <dbl>, A.25 <dbl>, A.26 <dbl>, A.27 <dbl>, A.28 <dbl>, A.29 <dbl>, A.30 <dbl>, A.31 <dbl>,
###   A.32 <dbl>, A.33 <dbl>, A.34 <dbl>, A.35 <dbl>, A.36 <dbl>, A.37 <dbl>, A.38 <dbl>, A.39 <dbl>,
###   A.40 <dbl>, A.41 <dbl>, A.42 <dbl>, A.43 <dbl>, A.44 <dbl>, A.45 <dbl>, A.46 <dbl>, A.47 <dbl>,
###   A.48 <dbl>, A.49 <dbl>, A.50 <dbl>, A.51 <dbl>, A.52 <dbl>, A.53 <dbl>, A.54 <dbl>, A.55 <dbl>,
###   A.56 <int>, A.57 <int>, spam <fct>
### ℹ Use `colnames()` to see all variable names

tr.idx <- sample(nrow(spam), 0.7*nrow(spam))
x <- as.matrix(spam[,-58]) # should be matrix
y <- as.integer(spam$spam =="spam") # integer valued
3.7.2.2 model fit & solution paths
library(glmnet)
# Fit models using spam data
fit.lasso <- glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=1) # lasso
fit.ridge <- glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=0) # ridge
fit.elnet <- glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=.8)
3.7.2.3 Plot solution paths
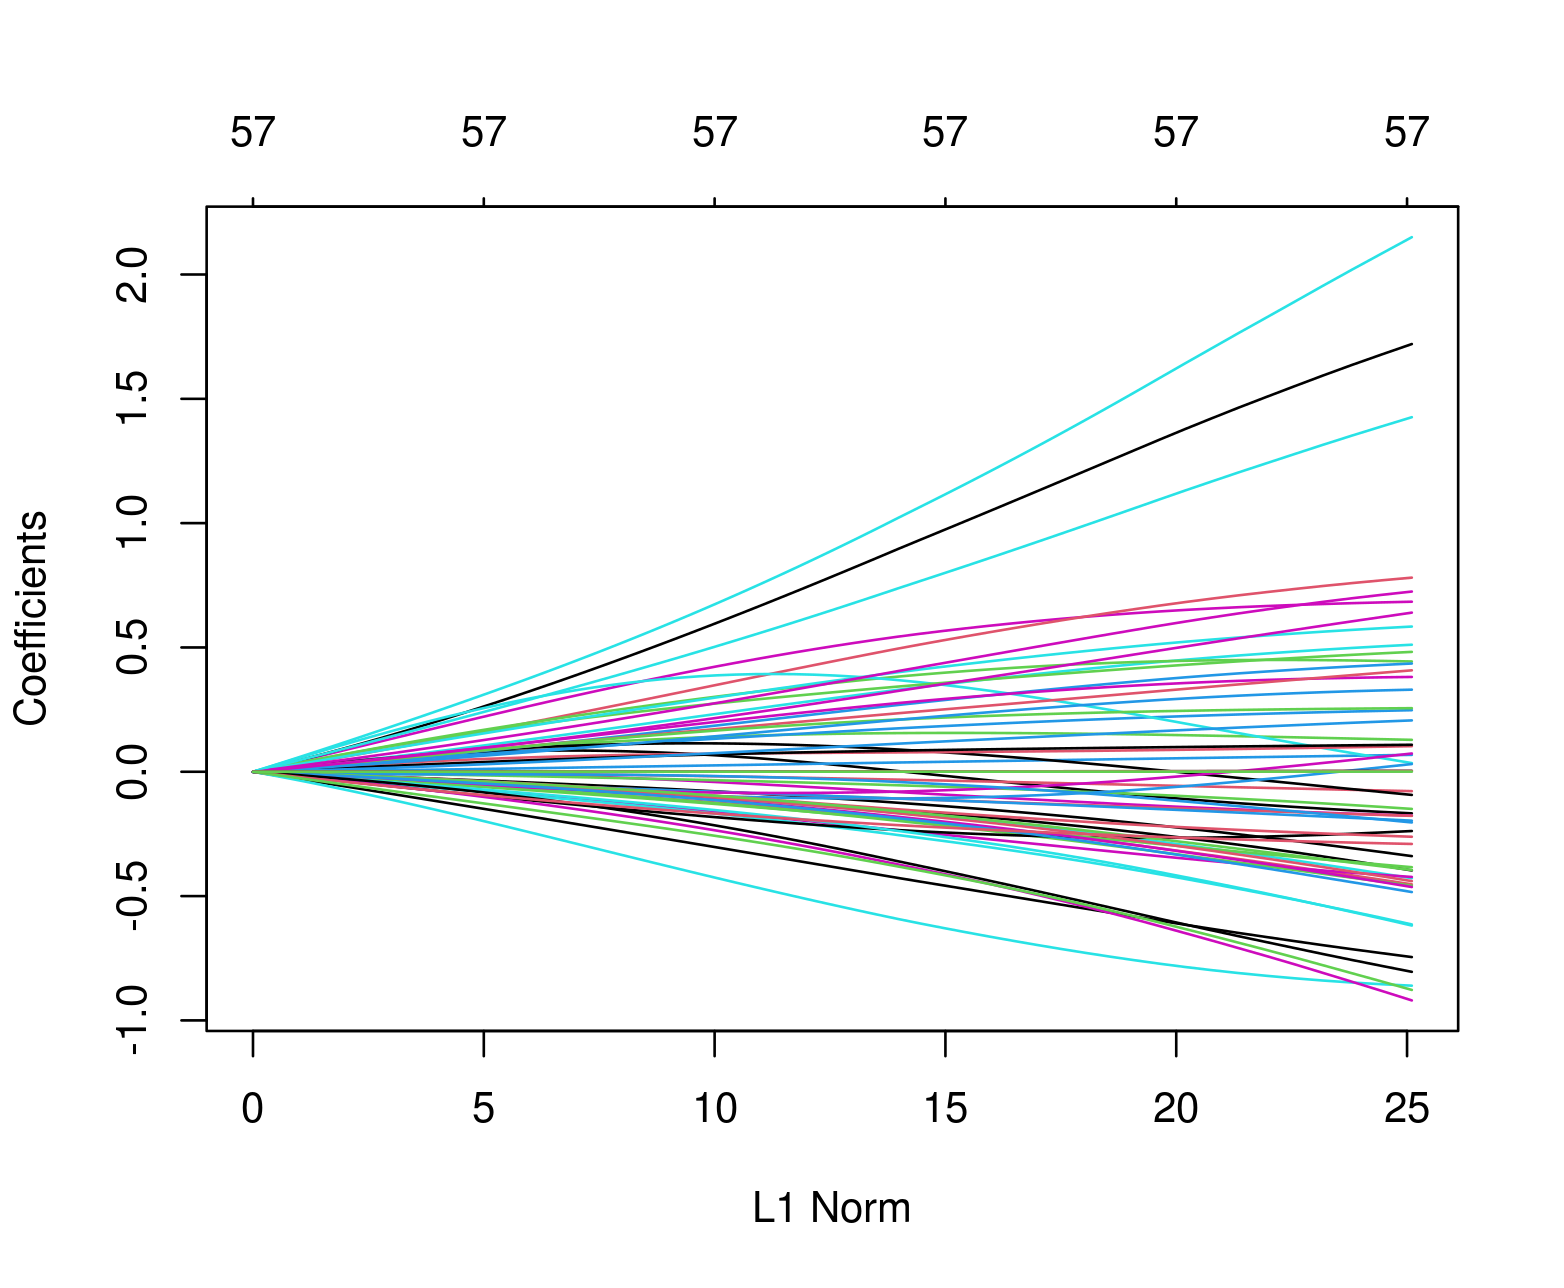
lasso vs ridge
plot(fit.lasso)
plot(fit.ridge)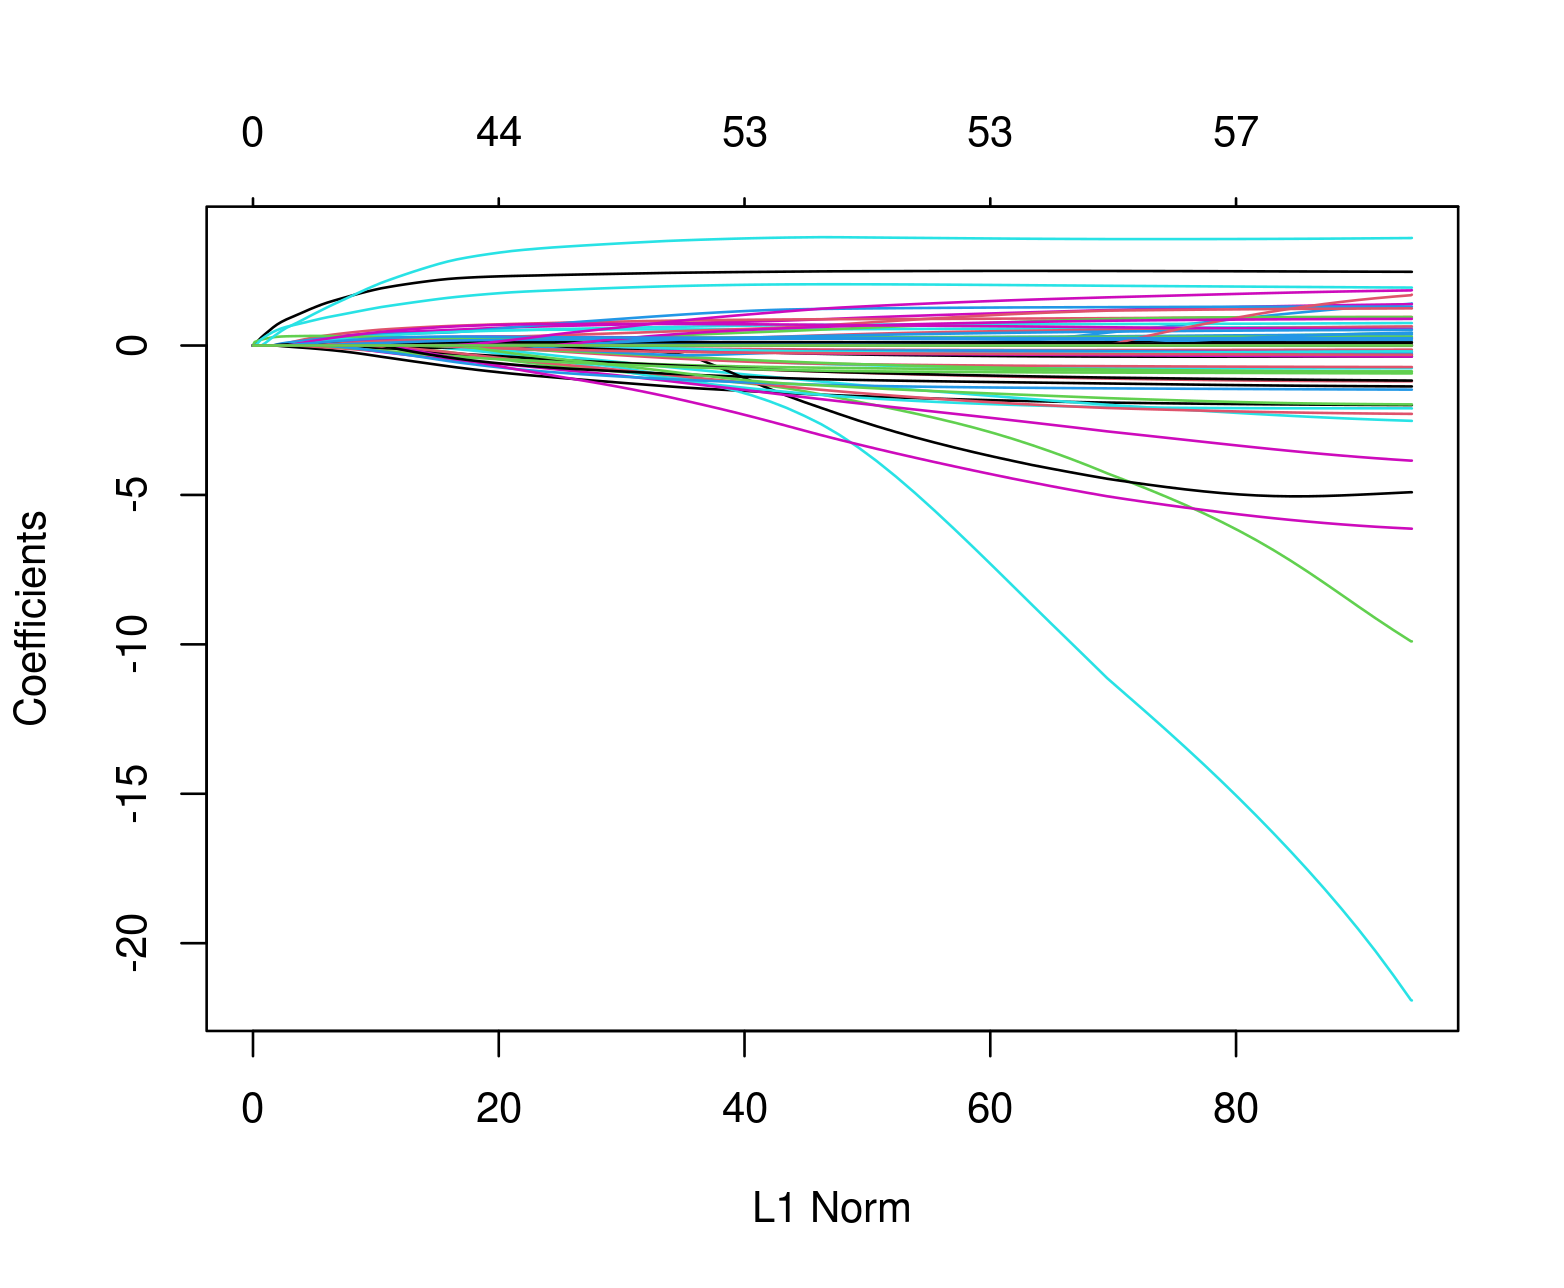
elastic net
plot(fit.elnet)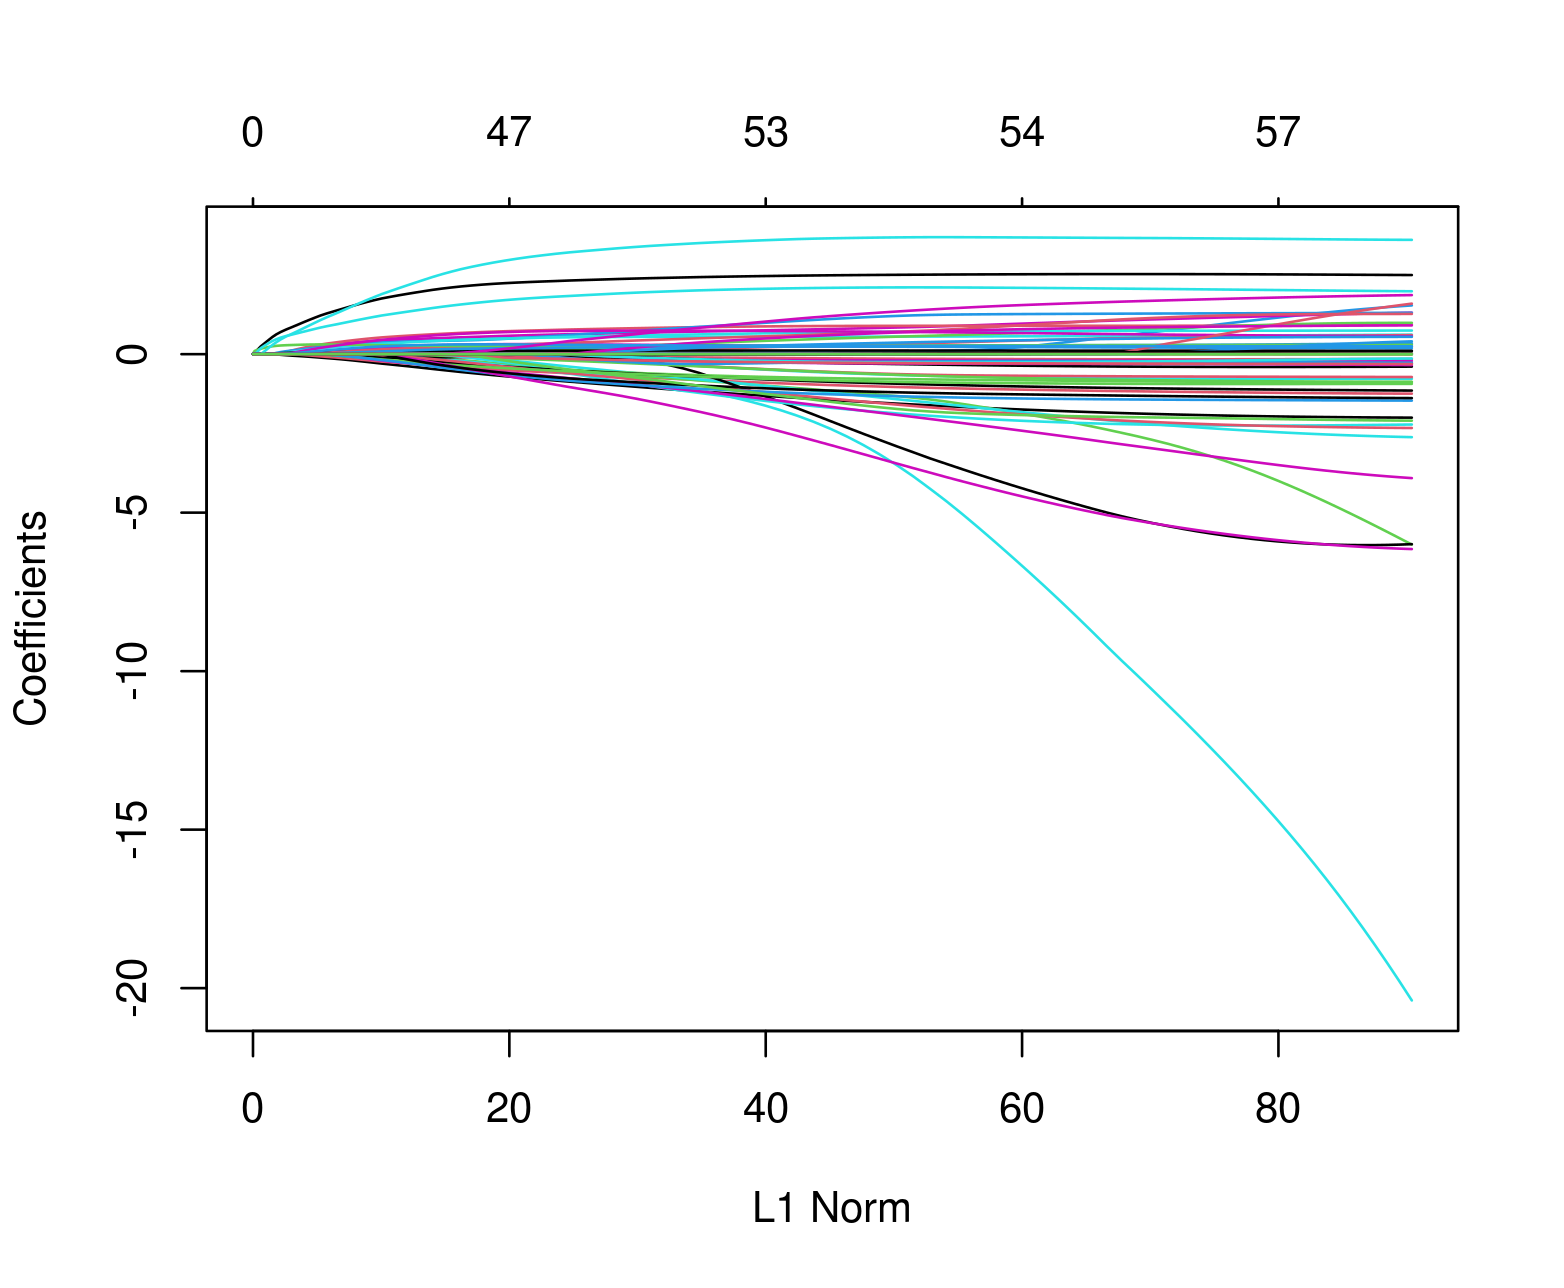
3.7.2.4 최적 조율모수 (\(\lambda\))의 탐색
cfit.lasso <- cv.glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=1)
cfit.ridge <- cv.glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=0)
cfit.elnet <- cv.glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=.8)

names(cfit.elnet)

## [1] "lambda"     "cvm"        "cvsd"       "cvup"       "cvlo"       "nzero"      "call"
## [8] "name"       "glmnet.fit" "lambda.min" "lambda.1se" "index"

cfit.lasso$lambda.min
## [1] 0.0005584

cfit.ridge$lambda.min
## [1] 0.01961

cfit.elnet$lambda.min
## [1] 0.0007661plot(cfit.elnet)3.7.2.5 최적모형 적합
fit2.lasso <- glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=1, lambda=cfit.lasso$lambda.min)
fit2.ridge <- glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=0, lambda=cfit.ridge$lambda.min)
fit2.elnet <- glmnet(x=x[tr.idx, ], y=y[tr.idx], family="binomial", alpha=.8, lambda=cfit.elnet$lambda.min)

names(fit2.elnet)
## [1] "a0"         "beta"       "df"         "dim"        "lambda"     "dev.ratio"  "nulldev"
## [8] "npasses"    "jerr"       "offset"     "classnames" "call"       "nobs"

head(coef(fit2.elnet))
## 6 x 1 sparse Matrix of class "dgCMatrix"
##                    s0
## (Intercept) -1.518930
## A.1         -0.211558
## A.2         -0.140536
## A.3          0.003083
## A.4          0.085219
## A.5          0.553358
3.7.2.6 모형평가
검증데이터의 예측
pred.lasso <- predict(fit2.lasso, newx=x[-tr.idx, ], type="response") #type="class"
pred.ridge <- predict(fit2.ridge, newx=x[-tr.idx, ], type="response") #type="class"
pred.elnet <- predict(fit2.elnet, newx=x[-tr.idx, ], type="response") #type="class"
오분류표의 계산
# Confusion Matrix

table(pred = pred.lasso>0.5, actual=y[-tr.idx])
##        actual
## pred      0   1
##   FALSE 784  51
##   TRUE   53 493

table(pred = pred.ridge>0.5, actual=y[-tr.idx])
##        actual
## pred      0   1
##   FALSE 788  77
##   TRUE   49 467

table(pred = pred.elnet>0.5, actual=y[-tr.idx])
##        actual
## pred      0   1
##   FALSE 787  55
##   TRUE   50 489