제 2 장 회귀분석과 로지스틱회귀분석 기초
2.1 회귀분석
2.1.1 회귀모형
- 데이터 \[ \begin{pmatrix} Y & X_{1} & X_{2} & ... & X_{p}\\ y_1 & x_{11} & x_{12} & ... & x_{1p}\\ y_2 & x_{21} & x_{22} & ... & x_{2p}\\ ...&...&...&...&...\\ y_n & x_{n1} & x_{n2} & ... & x_{np}\\ \end{pmatrix} \]
- 회귀모형: 확률변수 \(Y\)와 \(X_1, ..., X_p\)간의 함수관계를 추정하는 통계모형
\[
y = f(x_1, \ldots, x_p) + \epsilon,
\]
- \(Y\): 반응변수 (종속변수, 출력변수) - 영향을 받는 변수
- \(X_1, ..., X_p\): 설명변수 (독립변수, 입력변수) - 영향을 주는 변수
- \(f\): 회귀함수
- \(\epsilon\): 오차항 (기대값: 0, 분산: \(\sigma^2\))
- 선형회귀모형: 회귀함수 \(f\)가 아래와 같은 선형함수인 경우
\[
y = f(x_1, \ldots, x_p) + \epsilon= \beta_0 + \sum_{j=1}^p \beta_j x_j + \epsilon,
\]
- \(\beta_0, \ldots, \beta_p\): 회귀계수
- \(\epsilon \sim N(0, \sigma^2)\)
- Let \(\beta=(\beta_1, \beta_2, \ldots, \beta_p)^T\) and \(x=(x_1, \ldots, x_p)^T\) \[ y = f(\mathbf{x}) = \beta_0 + \beta^T \mathbf{x}. \]
2.1.2 회귀계수(\(\beta_j\))의 추정
최소제곱법: 아래의 식을 최소화 \[ \sum_{i=1}^n (y_i - (\beta_0 + \beta_1 x_{1i} +\ldots+ \beta_p x_{pi}))^2 \]
- 결과: \(\hat{\beta}= (X^T X)^{-1} X^T y\)
회귀계수에 대한 t 검정: (\(H_0: \beta_j = 0\)) \[ t= \frac{\hat \beta_j}{s.e(\beta_j)} \sim t(n-p) \]
2.1.3 회귀모형의 적합도 평가(goodness of fit):
- 결정계수(Coefficient of determination) \[ R^2 = \frac{SSR}{SST}= 1-\frac{SSE}{SST} = \frac{\sum_{i=1}^n(y_i - \hat y_i)^2}{\sum_{i=1}^n(y_i - \bar y)^2} \]
- 수정결정계수 \[ R_{adj}^2 = 1-\frac{SSE/n-p}{SST/n-1} = 1-\left(\frac{n-p}{n-1}\right)\frac{SSE}{SST} \]
- F 검정 \[ F = \frac{SSR/p}{SSE/(n-p-1)} = \frac{MSR}{MSE} \sim F(p, n-p-1). \]
2.1.4 단순선형회귀 예제
단순선형회귀: 입력변수가 하나인 경우의 회귀분석
데이터 예제
- 내년에 판매되는 에어컨 대수를 예측
- 지난 10년간의 에어컨 예약대수와 판매대수(1단위: 1,000대)
산점도 (scatter plot)
x <- c(11, 19, 23, 26, 29, 30, 38, 39, 46, 49)
y <- c(29, 33, 51, 40, 49, 50, 69, 70, 64, 89)
plot(x, y, xlab="x", ylab="y")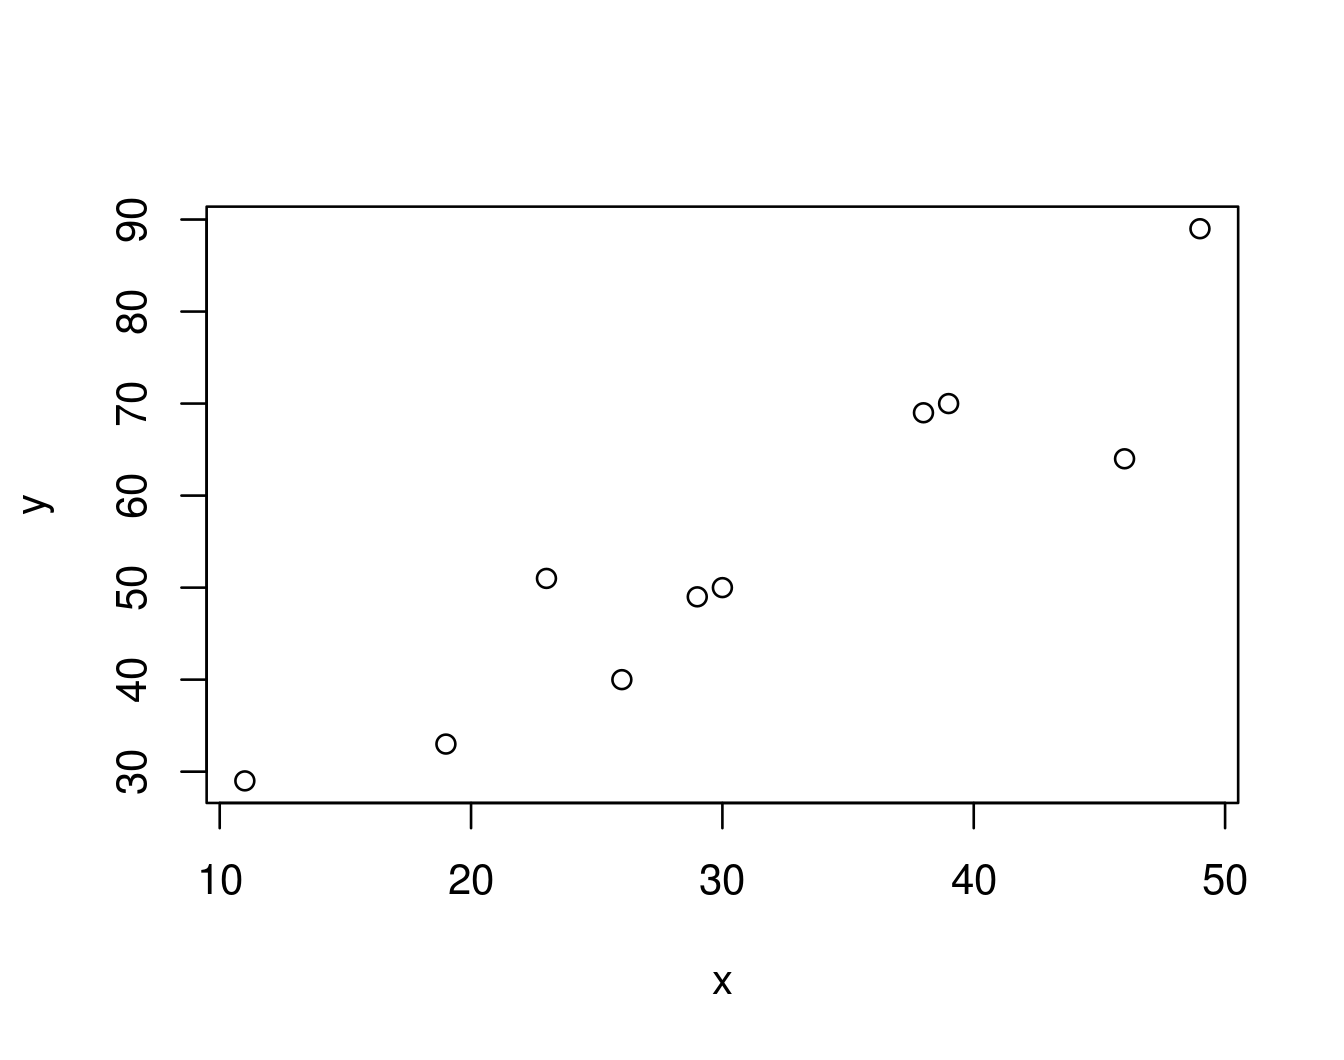
단순선형회귀 모형 \[ y_i=\beta_0+\beta_1 x_i+\epsilon_i, i=1,\ldots,n. \]
- \(x_i\): 에어컨 예약대수, \(y_i\): 에어컨 판매대수, \(\epsilon_i\): 오차항
- \(\beta_0\), \(\beta_1\): 미지의 상수, 모수(parameter)
회귀계수의 추정 : 최소제곱법
m1 <- lm(y~x); summary(m1)

## Call:
## lm(formula = y ~ x)
##
## Residuals:
##      Min       1Q   Median       3Q      Max
## -12.0115  -3.8229   0.4485   4.4044   8.6662
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept)   9.7362     6.6206   1.471     0.18
## x             1.4408     0.2004   7.188 9.35e-05 ***
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## Residual standard error: 7.227 on 8 degrees of freedom
## Multiple R-squared:  0.8659, Adjusted R-squared:  0.8492
## F-statistic: 51.67 on 1 and 8 DF, p-value: 9.354e-05 - 분산분석표 : 모형의 적합도
anova(m1)

## Analysis of Variance Table
##
## Response: y
##           Df  Sum Sq Mean Sq F value    Pr(>F)
## x          1 2698.56 2698.56  51.667 9.354e-05 ***
## Residuals  8  417.84   52.23
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
2.1.5 변수선택
다중회귀모형에서는 (의미가 있던 또는 없던지) 설명변수가 많이 포함될 수록 \(R^2\)이 커짐 (과적합)
변수선택법 : 유의한 설명 변수를 찾는 방법
- All possible subset regression
- 전진선택법 (Forward selection)
- 후진소거법 (Backward elimination)
- 단계적선택법 (Stepwise selection)
변수선택의 판정기준 (Selection Criterion)
- F-test
- Akaike Information Ceriterion (AIC)
- Bayesian Information Ceriterion (BIC)
\[ \mathrm {AIC} = -2 \ln(\hat {L}) + 2p \]
\[ \mathrm {BIC} = -2 \ln(\hat {L}) + 2\log(n) \]
2.1.6 범죄율 데이터의 다중회귀분석
- 데이터 -
UScrime- 처벌정책이 범죄율에 미치는 영향 연구 / 1960년 미국 47개주의 데이터
- 데이터 속성
변수명 변수설명 M 14-24세 남자인구 비율 So 남부 주(state)에 대한 지시변수(indicator variable) Ed 평균 교육(재학) 기간(년) Po1, Po2 1960, 1959년 경찰 유지비용 LF 고용율 M.F 성비: 여성 1,000명당 남성 비율 Pop 주 인구(단위 1,000명) NW 인구 1,000 명당 비백인수 U1,U2 14-24세, 35-39세 도시 남성의 실업률 GDP 1인당 주내 총생산량 Ineq 소득 불평등 지수 Prob 구속 확률 Time 재소자의 평균 구속 기간 y 특정 유형에 대한 범죄율(rescaled) - 반응변수
library(MASS)
head(UScrime)

##     M So  Ed Po1 Po2  LF  M.F Pop  NW  U1 U2 GDP Ineq     Prob    Time    y
## 1 151  1  91  58  56 510  950  33 301 108 41 394  261 0.084602 26.2011  791
## 2 143  0 113 103  95 583 1012  13 102  96 36 557  194 0.029599 25.2999 1635
## 3 142  1  89  45  44 533  969  18 219  94 33 318  250 0.083401 24.3006  578
## 4 136  0 121 149 141 577  994 157  80 102 39 673  167 0.015801 29.9012 1969
## 5 141  0 121 109 101 591  985  18  30  91 20 578  174 0.041399 21.2998 1234
## 6 121 0 110 118 115 547 964 25 44 84 29 689 126 0.034201 20.9995 682 - 산점도 (scatter plot)
par(mfrow=c(2,2))
for(i in 12:15) plot(UScrime[, c(i,16)])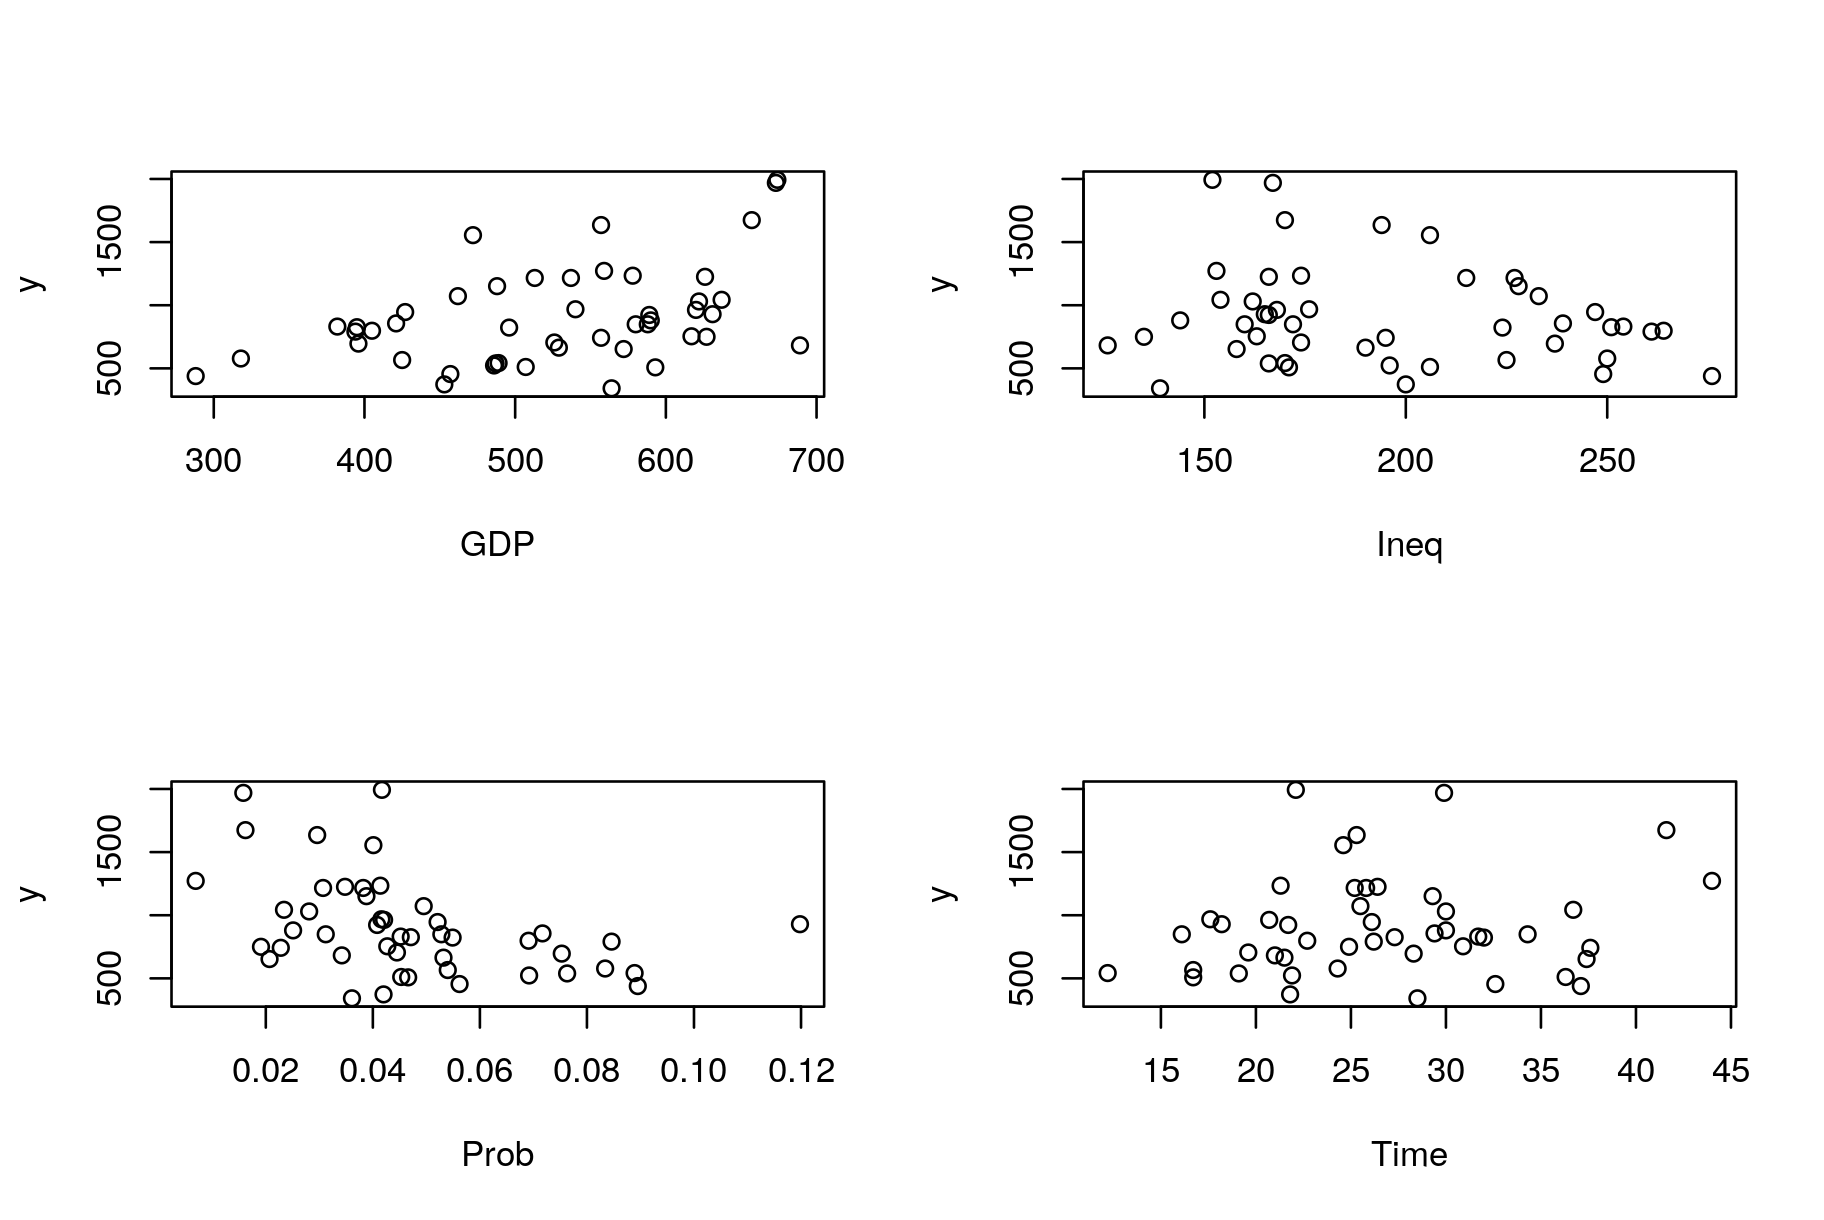
- 상관계수
x <- UScrime[,12:16]
cor(x)

##             GDP    Ineq    Prob       Time       y
## GDP   1.0000000 -0.8840 -0.5553  0.0006486  0.4413
## Ineq -0.8839973  1.0000  0.4653  0.1018228 -0.1790
## Prob -0.5553347  0.4653  1.0000 -0.4362463 -0.4274
## Time  0.0006486  0.1018 -0.4362  1.0000000  0.1499
## y 0.4413199 -0.1790 -0.4274 0.1498661 1.0000 - 다중선형회귀모형의 추정
m1 <- lm(y~., data=UScrime)
summary(m1)

## Call:
## lm(formula = y ~ ., data = UScrime)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -395.7  -98.1   -6.7  113.0  512.7
## Coefficients:
##              Estimate Std. Error t value Pr(>|t|)
## (Intercept) -5984.288   1628.318   -3.68  0.00089 ***
## M               8.783      4.171    2.11  0.04344 *
## So             -3.803    148.755   -0.03  0.97977
## Ed             18.832      6.209    3.03  0.00486 **
## Po1            19.280     10.611    1.82  0.07889 .
## Po2           -10.942     11.748   -0.93  0.35883
## LF             -0.664      1.470   -0.45  0.65465
## M.F             1.741      2.035    0.86  0.39900
## Pop            -0.733      1.290   -0.57  0.57385
## NW              0.420      0.648    0.65  0.52128
## U1             -5.827      4.210   -1.38  0.17624
## U2             16.780      8.234    2.04  0.05016 .
## GDP             0.962      1.037    0.93  0.36075
## Ineq            7.067      2.272    3.11  0.00398 **
## Prob        -4855.266   2272.375   -2.14  0.04063 *
## Time           -3.479      7.165   -0.49  0.63071
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## Residual standard error: 209 on 31 degrees of freedom
## Multiple R-squared:  0.803,  Adjusted R-squared:  0.708
## F-statistic: 8.43 on 15 and 31 DF, p-value: 3.54e-07 - 변수선택(단계적선택법 - AIC)
s1 <- step(m1)

## Start:  AIC=514.6
## y ~ M + So + Ed + Po1 + Po2 + LF + M.F + Pop + NW + U1 + U2 +
##     GDP + Ineq + Prob + Time
##
##        Df Sum of Sq     RSS AIC
## - So    1        29 1354974 513 <== 현재 모형에서 So 제거시 모형
## - LF    1      8917 1363862 513
## - Time  1     10304 1365250 513
## - Pop   1     14122 1369068 513
## - NW    1     18395 1373341 513
## - M.F   1     31967 1386913 514
## - GDP   1     37613 1392558 514
## - Po2   1     37919 1392865 514
## <none>              1354946 515 <== 현재 모형
## - U1    1     83722 1438668 515
## - Po1   1    144306 1499252 517
## - U2    1    181536 1536482 519
## - M     1    193770 1548716 519
## - Prob  1    199538 1554484 519
## - Ed    1    402117 1757063 525
## - Ineq  1    423031 1777977 525
##
## Step: AIC=512.6
## y ~ M + Ed + Po1 + Po2 + LF + M.F + Pop + NW + U1 + U2 + GDP +
## Ineq + Prob + Time
##
## Df Sum of Sq RSS AIC
## - Time 1 10341 1365315 511
## - LF 1 10878 1365852 511
## - Pop 1 14127 1369101 511
## - NW 1 21626 1376600 511
## - M.F 1 32449 1387423 512
## - Po2 1 37954 1392929 512
## - GDP 1 39223 1394197 512
## <none> 1354974 513
## - U1 1 96420 1451395 514
## - Po1 1 144302 1499277 515
## - U2 1 189859 1544834 517
## - M 1 195084 1550059 517
## - Prob 1 204463 1559437 517
## - Ed 1 403140 1758114 523
## - Ineq 1 488834 1843808 525
##
## Step: AIC=511
## y ~ M + Ed + Po1 + Po2 + LF + M.F + Pop + NW + U1 + U2 + GDP +
## Ineq + Prob
##
## Df Sum of Sq RSS AIC
## - LF 1 10533 1375848 509
## - NW 1 15482 1380797 510
## - Pop 1 21846 1387161 510
## - Po2 1 28932 1394247 510
## - GDP 1 36070 1401385 510
## - M.F 1 41784 1407099 510
## <none> 1365315 511
## - U1 1 91420 1456735 512
## - Po1 1 134137 1499452 513
## - U2 1 184143 1549458 515
## - M 1 186110 1551425 515
## - Prob 1 237493 1602808 517
## - Ed 1 409448 1774763 521
## - Ineq 1 502909 1868224 524
##
## Step: AIC=509.4
## y ~ M + Ed + Po1 + Po2 + M.F + Pop + NW + U1 + U2 + GDP + Ineq +
## Prob
##
## Df Sum of Sq RSS AIC
## - NW 1 11675 1387523 508
## - Po2 1 21418 1397266 508
## - Pop 1 27803 1403651 508
## - M.F 1 31252 1407100 508
## - GDP 1 35035 1410883 509
## <none> 1375848 509
## - U1 1 80954 1456802 510
## - Po1 1 123896 1499744 511
## - U2 1 190746 1566594 513
## - M 1 217716 1593564 514
## - Prob 1 226971 1602819 515
## - Ed 1 413254 1789103 520
## - Ineq 1 500944 1876792 522
##
## Step: AIC=507.8
## y ~ M + Ed + Po1 + Po2 + M.F + Pop + U1 + U2 + GDP + Ineq + Prob
##
## Df Sum of Sq RSS AIC
## - Po2 1 16706 1404229 506
## - Pop 1 25793 1413315 507
## - M.F 1 26785 1414308 507
## - GDP 1 31551 1419073 507
## <none> 1387523 508
## - U1 1 83881 1471404 509
## - Po1 1 118348 1505871 510
## - U2 1 201453 1588976 512
## - Prob 1 216760 1604282 513
## - M 1 309214 1696737 515
## - Ed 1 402754 1790276 518
## - Ineq 1 589736 1977259 522
##
## Step: AIC=506.3
## y ~ M + Ed + Po1 + M.F + Pop + U1 + U2 + GDP + Ineq + Prob
##
## Df Sum of Sq RSS AIC
## - Pop 1 22345 1426575 505
## - GDP 1 32142 1436371 505
## - M.F 1 36808 1441037 506
## <none> 1404229 506
## - U1 1 86373 1490602 507
## - U2 1 205814 1610043 511
## - Prob 1 218607 1622836 511
## - M 1 307001 1711230 514
## - Ed 1 389502 1793731 516
## - Ineq 1 608627 2012856 521
## - Po1 1 1050202 2454432 531
##
## Step: AIC=505.1
## y ~ M + Ed + Po1 + M.F + U1 + U2 + GDP + Ineq + Prob
##
## Df Sum of Sq RSS AIC
## - GDP 1 26493 1453068 504
## <none> 1426575 505
## - M.F 1 84491 1511065 506
## - U1 1 99463 1526037 506
## - Prob 1 198571 1625145 509
## - U2 1 208880 1635455 509
## - M 1 320926 1747501 513
## - Ed 1 386773 1813348 514
## - Ineq 1 594779 2021354 519
## - Po1 1 1127277 2553852 530
##
## Step: AIC=503.9
## y ~ M + Ed + Po1 + M.F + U1 + U2 + Ineq + Prob
##
## Df Sum of Sq RSS AIC
## <none> 1453068 504
## - M.F 1 103159 1556227 505
## - U1 1 127044 1580112 506
## - Prob 1 247978 1701046 509
## - U2 1 255443 1708511 510
## - M 1 296790 1749858 511
## - Ed 1 445788 1898855 515
## - Ineq 1 738244 2191312 521
## - Po1 1 1672038 3125105 538 최종 모형: 단계적선택법을 적용한 결과
summary(s1)

#              Estimate Std. Error t value Pr(>|t|)
# (Intercept) -6426.101   1194.611  -5.379 4.04e-06 ***
# M               9.332      3.350   2.786  0.00828 **
# Ed             18.012      5.275   3.414  0.00153 **
# Po1            10.265      1.552   6.613 8.26e-08 ***
# M.F             2.234      1.360   1.642  0.10874
# U1             -6.087      3.339  -1.823  0.07622 .
# U2             18.735      7.248   2.585  0.01371 *
# Ineq            6.133      1.396   4.394 8.63e-05 ***
# Prob        -3796.032   1490.646  -2.547  0.01505 *
# ---
# Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
#
# Residual standard error: 195.5 on 38 degrees of freedom
# Multiple R-squared:  0.7888,  Adjusted R-squared:  0.7444
# F-statistic: 17.74 on 8 and 38 DF,  p-value: 1.159e-10
원자료와 최초모형의 추정결과 비교
plot(UScrime$y, s1$fitted.values, xlab="범죄율(y)", ylab="범죄율 추정치(hat_y)")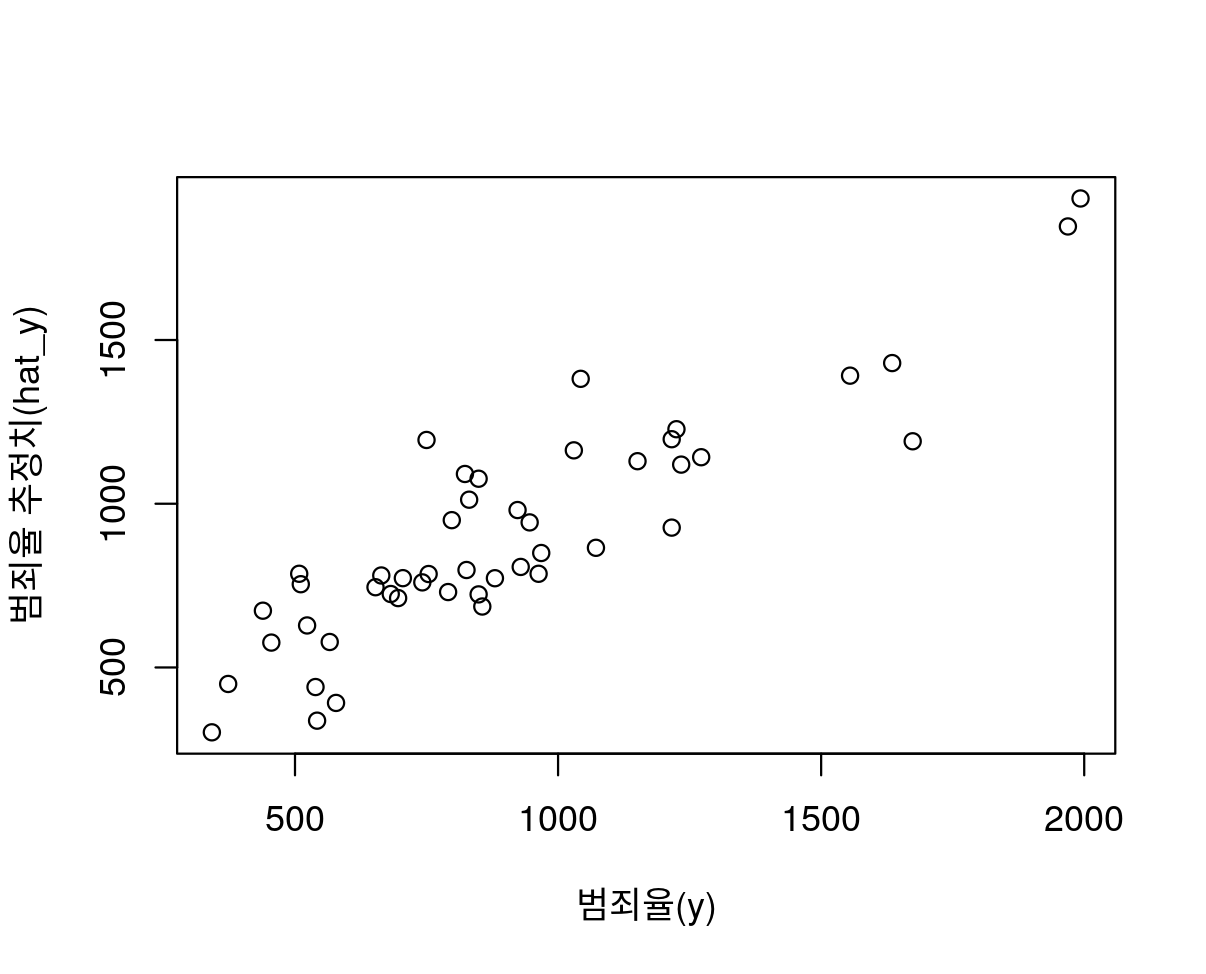
2.1.7 일부 자료를 이용한 모형적합
for(i in 1:2){
  omit_idx <- sample(nrow(UScrime), 5)
  cat("========== Detete ids =", omit_idx, "====================\n")
  m2 <- lm(y~., data=UScrime[-omit_idx,])
  s2 <- step(m2, trace=F)
  print(summary(s2))
}

## ========== Detete ids = 7 9 36 33 32 ====================
##
## Call:
## lm(formula = y ~ M + Ed + Po1 + M.F + U1 + U2 + Ineq + Prob,
##     data = UScrime[-omit_idx, ])
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -407.3 -110.4    7.6  114.9  511.3
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) -6602.11    1230.77   -5.36  6.3e-06 ***
## M               8.35       3.65    2.29  0.02866 *
## Ed             18.55       5.57    3.33  0.00215 **
## Po1            10.53       1.65    6.37  3.2e-07 ***
## M.F             2.33       1.40    1.67  0.10508
## U1             -5.32       3.53   -1.51  0.14103
## U2             17.83       7.84    2.27  0.02963 *
## Ineq            6.44       1.57    4.10  0.00025 ***
## Prob        -3465.40    1586.26   -2.18  0.03612 *
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## Residual standard error: 199 on 33 degrees of freedom
## Multiple R-squared:  0.804,  Adjusted R-squared:  0.757
## F-statistic: 16.9 on 8 and 33 DF,  p-value: 1.19e-09
##
## ========== Detete ids = 9 8 32 13 23 ====================
##
## Call:
## lm(formula = y ~ M + Ed + Po1 + M.F + U1 + U2 + Ineq + Prob,
##     data = UScrime[-omit_idx, ])
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -434.0 -115.8   20.5  116.0  518.5
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) -6667.60    1211.60   -5.50  4.2e-06 ***
## M               9.63       3.56    2.71  0.01065 *
## Ed             19.77       5.42    3.65  0.00090 ***
## Po1             9.51       1.58    6.01  9.3e-07 ***
## M.F             2.34       1.35    1.73  0.09325 .
## U1             -6.35       3.39   -1.87  0.07015 .
## U2             20.29       7.41    2.74  0.00991 **
## Ineq            5.75       1.49    3.87  0.00048 ***
## Prob        -3582.19    1499.19   -2.39  0.02275 *
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## Residual standard error: 193 on 33 degrees of freedom
## Multiple R-squared:  0.801,  Adjusted R-squared:  0.753
## F-statistic: 16.6 on 8 and 33 DF,  p-value: 1.5e-09
2.2 로지스틱 회귀
2.2.1 로지스틱 회귀 모형
- 선형회귀모형
- 반응변수가 연속형인 경우 \[ E(y|x_1, x_2, \ldots, x_p) = \beta_0 + \sum_{j=1}^p \beta_j x_j. \]
- 로지스틱 회귀모형(logistic regression)
- 반응변수가 이진형인 경우 (\(y \in \{0,1\}\)) \[ \log\left(\frac{P(y=1|x)}{1-P(y=1|x)}\right) = \beta_0 + \sum_{j=1}^p \beta_j x_j, \] 이를 다시 \(P(Y=1|x)\)에 대하여 정리하면, \[ P(Y=1|x) = \frac{\exp(\beta_0 + \sum_{j=1}^p \beta_j x_j)}{1+\exp(\beta_0+ \sum_{j=1}^p \beta_j x_j)}. \]
- 로지스틱 함수의 형태
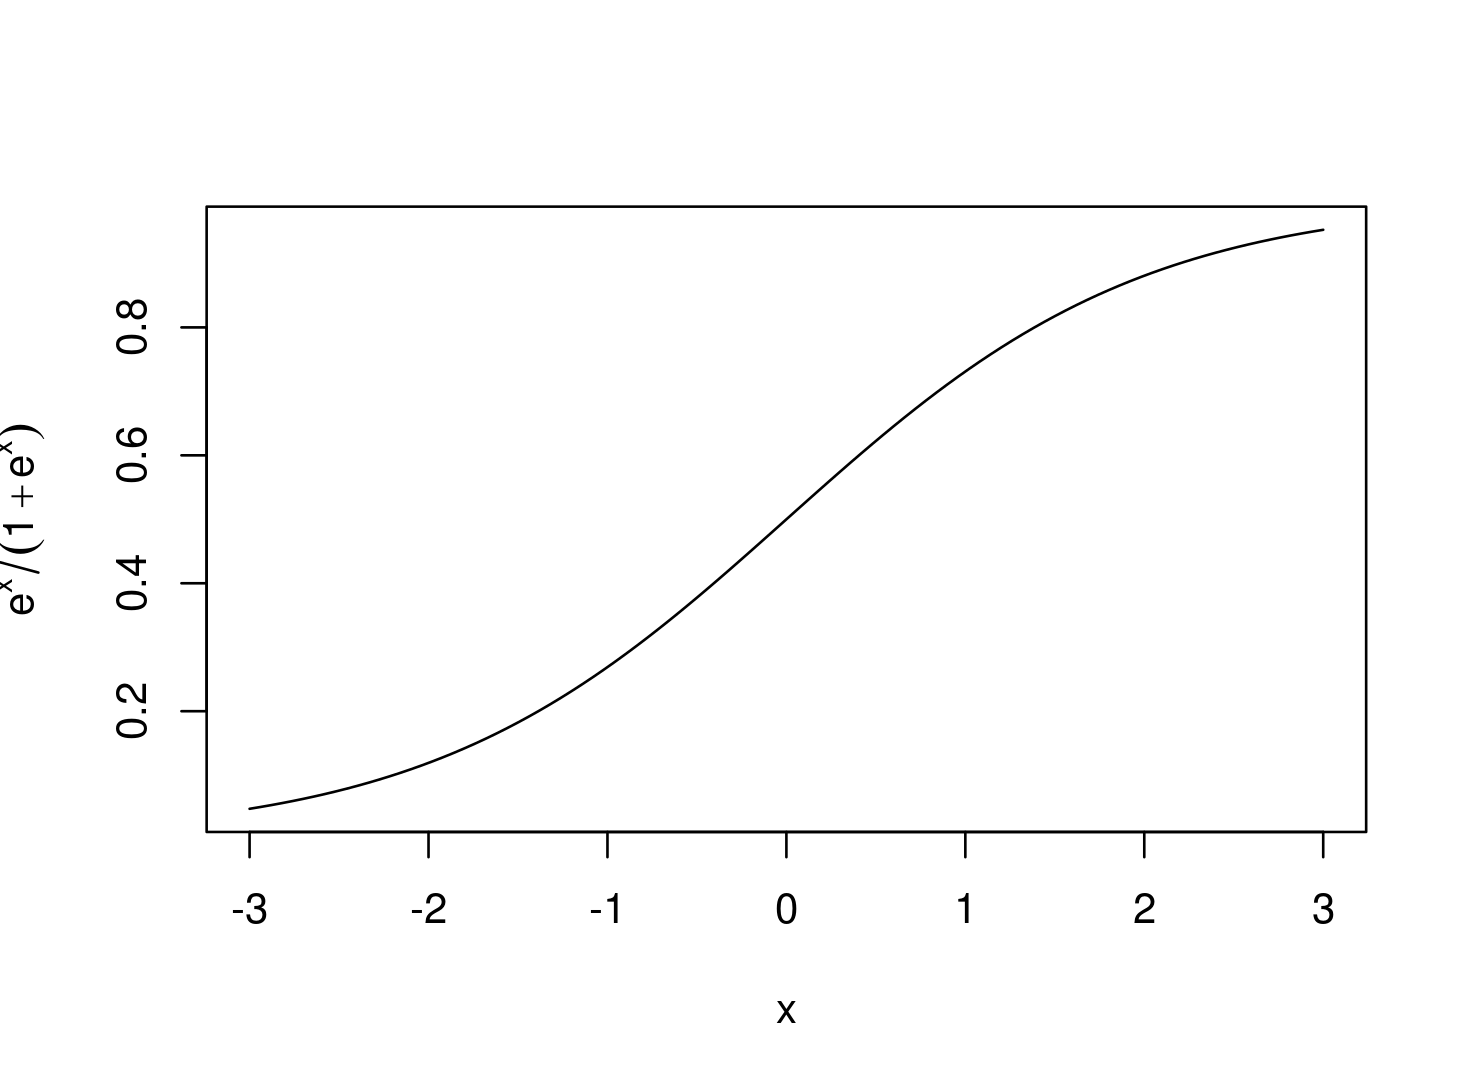
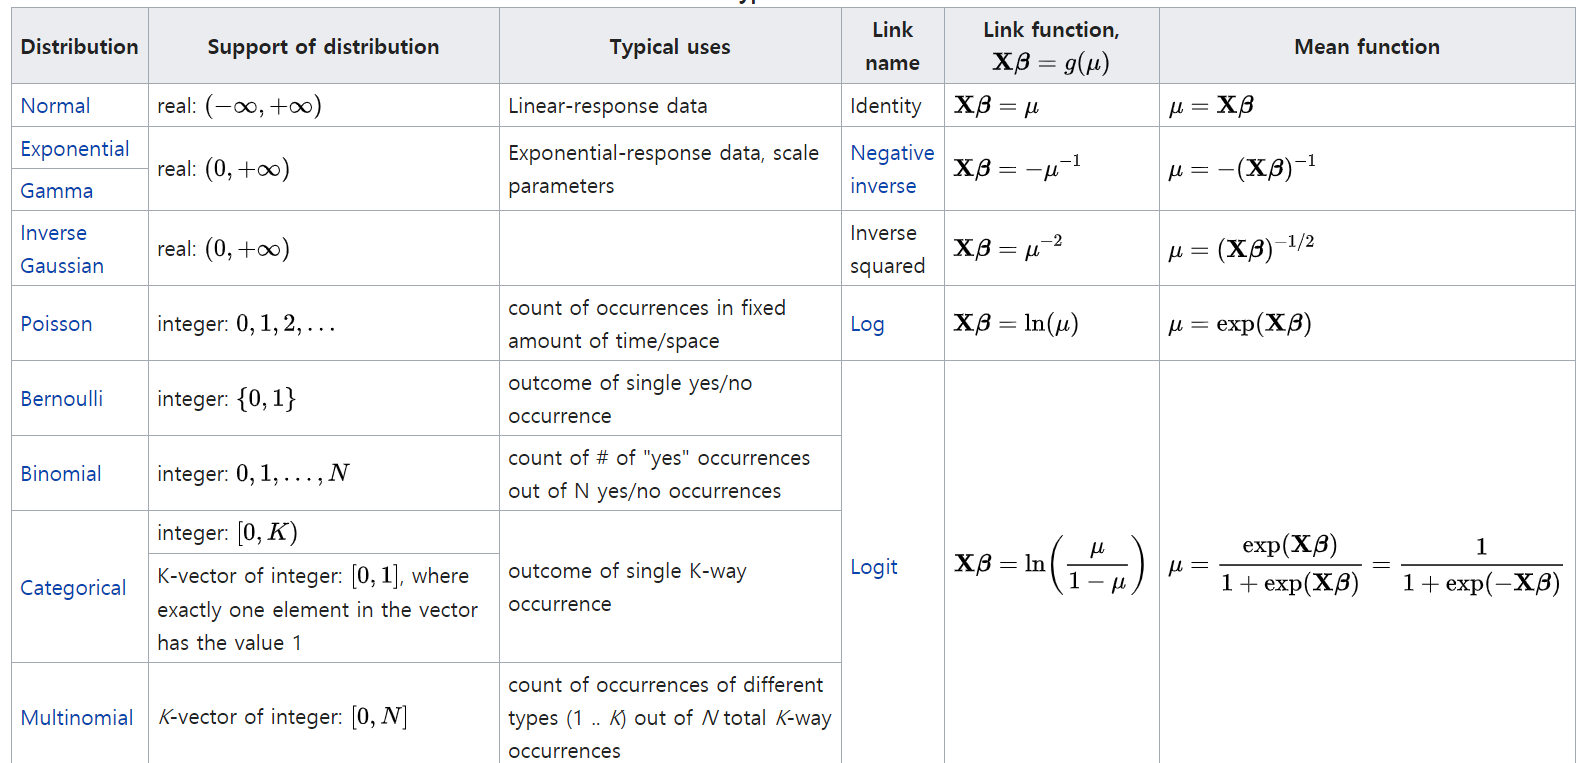
정의 2.1 (일반화 선형모형)
- \(y\)를 종속변수이고 어떤 분포를 따른다고 하자. 이 때, 어떤 분포는 지수족(exponential family)이고, 주로 정규분포, 포아송, 감마, 이항분포 등이다.
- \(Y\)의 기대값(평균, \(E(y) = \mu\))이 독립변수의 함수로 표현된다고 하자. 즉, \[ E (y)=\mu = g^{-1} (\beta_0+ \sum_{j=1}^p \beta_j x_j) \]
- 위에서 \(\beta_0+ \sum_{j=1}^p \beta_j x_j\)는 선형예측기(linear predictor)라고 부르고,
- \(\mu = g^{-1} (\beta_0+ \sum_{j=1}^p \beta_j x_j)\)을 평균함수(mean function),
- \(g()\)를 연결함수(link function)이라고 함
- 이러한 일반화 선형모형은 다양한 분포에서 회귀모형을 적합시킬 수 있음
2.2.2 로지스틱 회귀모형의 해석
| smoking(x=1) | non-smoking(x=0) | total | |
|---|---|---|---|
| lung cancer(\(y=1\)) | a | c | \(n_1\) |
| non (\(y=0\)) | b | d | \(n_0\) |
| Total | \(m_1\) | \(m_0\) | \(N\) |
- Risk Ratio(RR)
- 흡연의 폐암 발생률을 비흡연의 폐암 발생률로 나눈 값 \[ RR = \frac{P(Y=1|x=1)}{P(Y=1|x=0)} = \frac{a/m_1}{c/m_0} =\frac{a/(a+b)}{c/(c+d)} \]
- 오즈 (odds)
- 흡연(비흡연)의 폐암 확률을 흡연(비흡연)의 폐암이 발생하지 않을 확률로 나눈 값, 특정 리스크(흡연)에 노출될 경우의 상대대위험도로 해석 \[ \text{odds}(x=1) = \frac{P(Y=1|x=1)}{P(Y=0|x=1)} = \frac{a/m_1}{b/m_1} = \frac{a/(a+b)}{b/(a+b)} = \frac{a}{b} \]
- 오즈비 (odds ratio)
- 설명변수 \(x=1\)에서의 오즈와 \(x=0\)에서의 오즈의 비 - \(x\)가 한 단위 증가할 때 \(y=1\)일 위험과 \(y=0\)일 위험의 비의 증가율 - 특정 리스크에 노출될 경우, 그렇지 않은 경우에 대한 상대적 위험도 \[ \frac{P(Y=1|x=1)/P(Y=0|x=1)}{P(Y=1|x=0)/P(Y=0|x=0)} = \exp(\beta_1). \]
- RR vs OR
- 리스크에 노출되지 않을 경우 질병에 걸릴 확률)이 아주 작으면 (희귀성의 가정), \(RR \approx OR\)
- 로그 오즈비 (log odds ratio)
- 오즈비에 로그를 취한 값으로 로지스틱 모형의 회귀계수와 일치
예제 2.1 \(x\)는 흡연 유무이고 \(y\)는 폐질환 여부 (1, 0)
\(\hat{\beta}=3.72 \to \text{odds ratio} =\exp(3.72) = 42\)
흡연자의 폐질환에 대한 위험이 비흡연자의 위험에 비해 42배 증가하는 것으로 해석
2.2.3 예제: 로지스틱 회귀
데이터 : 전립선암 (Prostate Cancer) 데이터
림프절이 전립선암에 대해 양성인지 여부
53명의 환자자료
변수 설명
변수명 변수 설명 aged 환자의 연령 stage 질병 단계: 질병이 얼마나 진행되어 있는지 나타내는 측도 grade 종양의 등급: 진행의 정도 xray X-선 결과 acid 혈청인산염(serum acid phosphatase) 특정한 부위에 종양이 전이되었을 때 상승되는 혈청의 인산염값 r 전립선암 양성(1) 여부 데이터
library(boot)
x <- nodal[,-1]
head(x, 20)

##    r aged stage grade xray acid
## 1  1    0     1     1    1    1
## 2  1    0     1     1    1    1
## 3  1    0     1     1    1    1
## 4  1    0     1     1    1    1
## 5  1    0     1     1    1    1
## 6  0    0     1     1    1    1
## 7  1    0     0     0    0    1
## 8  0    0     0     0    0    1
## 9  0    0     0     0    0    1
## 10 0    0     0     0    0    1
## 11 0    0     0     0    0    1
## 12 0    0     0     0    0    1
## 13 0    1     1     1    0    0
## 14 0    1     1     1    0    0
## 15 0    1     1     1    0    0
## 16 0    1     1     1    0    0
## 17 1    1     1     0    0    1
## 18 1    1     1     0    0    1
## 19 0    1     1     0    0    1
## 20 0 1 1 0 0 1 - 모형 적합
gfit = glm(r~., data=x, family="binomial")
summary(gfit)$coefficients

##             Estimate Std. Error z value Pr(>|z|)
## (Intercept)  -3.0794     0.9868 -3.1207 0.001804
## aged         -0.2917     0.7540 -0.3869 0.698813
## stage         1.3729     0.7838  1.7515 0.079856
## grade         0.8720     0.8156  1.0691 0.285004
## xray          1.8008     0.8104  2.2221 0.026278
## acid 1.6839 0.7915 2.1276 0.033371 - 변수선택 (단계적 선택법)
gfit2 <- step(gfit, trace=F)
summary(gfit2)

## Call:
## glm(formula = r ~ stage + xray + acid, family = "binomial", data = x)
##
## Deviance Residuals:
##    Min      1Q  Median      3Q     Max
## -2.123  -0.662  -0.304   0.471   2.489
##
## Coefficients:
##             Estimate Std. Error z value Pr(>|z|)
## (Intercept)   -3.052      0.842   -3.62  0.00029 ***
## stage          1.645      0.730    2.25  0.02414 *
## xray           1.912      0.777    2.46  0.01390 *
## acid           1.638      0.754    2.17  0.02983 *
## ---
## Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
##
## (Dispersion parameter for binomial family taken to be 1)
##
##     Null deviance: 70.252  on 52  degrees of freedom
## Residual deviance: 49.180  on 49  degrees of freedom
## AIC: 57.18
##
## Number of Fisher Scoring iterations: 5
결과를 해석하면
- 유의한 변수들(유의확률: \(p<0.05\))은 전립선암에 영향을 줌
- 질병의 단계(
stage)가 심화 - X-선 결과(
xray)가 좋지 않을수록 - 혈청인산염 값(
acid)이 높을수록
- 질병의 단계(
stage(질병의 단계)의 오즈비- \(\exp(1.645346) = 5.18280\)
- 질병의 진행단계가 심화된 그룹은 그렇지 않은 그룹에 비해 전립선암에 노출 위험이 약 5.2배 정도 높음
과제 1
각자 로지스틱분석에 필요한 데이터를 찾아서 데이터를 소개하고 분석하세요.
제출기한: 2023년 4월 6일 수업전까지
제출방법: A4용지 하드카피로 제출
제출 후 데이터 및 분석 결과 발표 (5분이내)
보고서 형식은 아래의 내용이 포함되도록 구성할 것
- 서론: 데이터와 분석목적
- 분석 절차 및 결과
- 결과의 해석
- 결론 및 토의
데이터 소스가 있는 사이트 참고
Kaggle : https://www.kaggle.com/datasets
건강보험심사평가원 공공데이터: https://www.hira.or.kr/dummy.do?pgmid=HIRAA070001000430&WT.gnb=%EA%B3%B5%EA%B3%B5%EB%8D%B0%EC%9D%B4%ED%84%B0+%EA%B0%9C%EB%B0%A9
UCI Machine Learning repository: https://archive.ics.uci.edu/ml/datasets.php
Awesome Public Datasets (github): https://github.com/awesomedata/awesome-public-datasets